世界模型
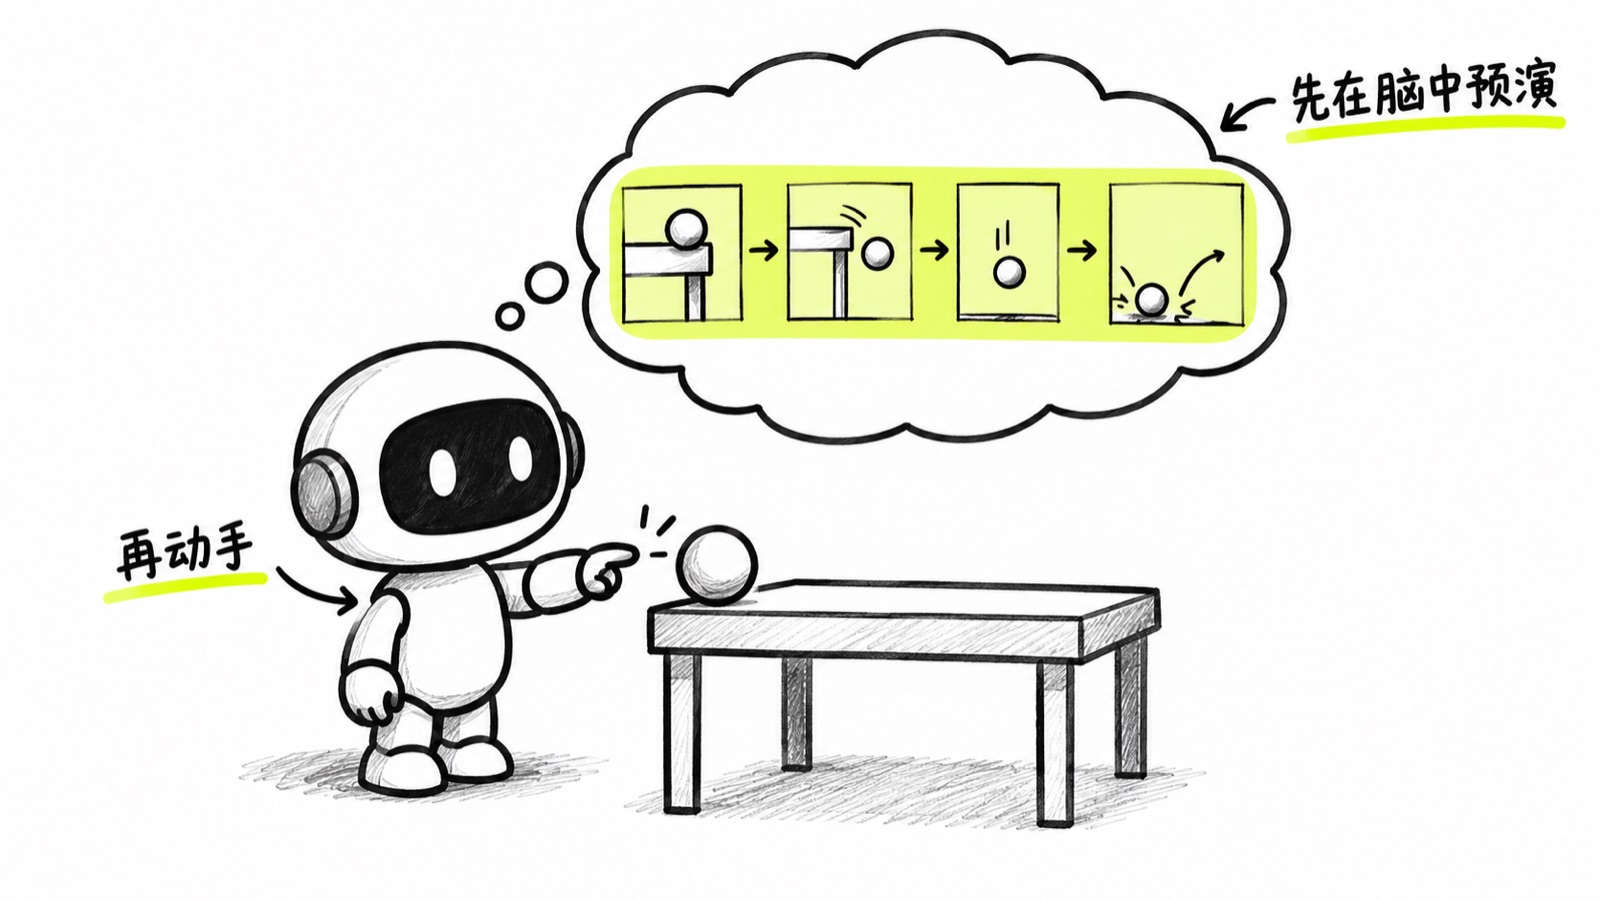
- 说人话
- 人伸手之前会先在脑子里过一遍:这么一推,杯子会掉下去。这类常识几乎没人专门写成文字,模型从书里读不到,只能从视频和反复试错里学:眼下是这个样子,我做这个动作,下一刻会变成什么样。你会在机器人演示、自动驾驶仿真,以及能用方向键实时操控的生成画面里碰到它。
- 说行话
- 英文 World Model。查论文要认两个关键词:latent dynamics 指在压缩后的状态空间里推演,action-conditioned 指按给定动作预测下一刻。落到产业里,它集中在具身智能和自动驾驶仿真的管线上。
- 潜台词
- 这个词眼下被三拨人同时在用:做可交互视频生成的、做机器人的、找下一代 AI 路线的,说的往往不是一回事。
- 别用它
- 别把视频生成模型直接当世界模型。画面逼真不等于懂物理,东西会凭空消失、互相穿模的就还不算。
拿这个能做什么4 个项目
- 01
- 02
- 03
- 04
LLM 从文字里学到的是世界被怎么描述,世界模型想学的是世界怎么运转。这是下一代路线之争的核心,但对做应用的人来说,它眼下还是研究方向,不是能直接接进产品的工具。
动手试试做完就算会了
打开 rtfm.worldlabs.ai,开发者工具的 Network 里看 ws 连接的 Messages:站着不动只有几十字节的心跳,按住 W 一走,每条变成几十 KB 的 512×512 JPEG。拖右摇杆四处看看再点 recenter,画面和进场第一帧几乎一样:画过的帧按位置存着,回原处就拿来当底稿。