向量数据库
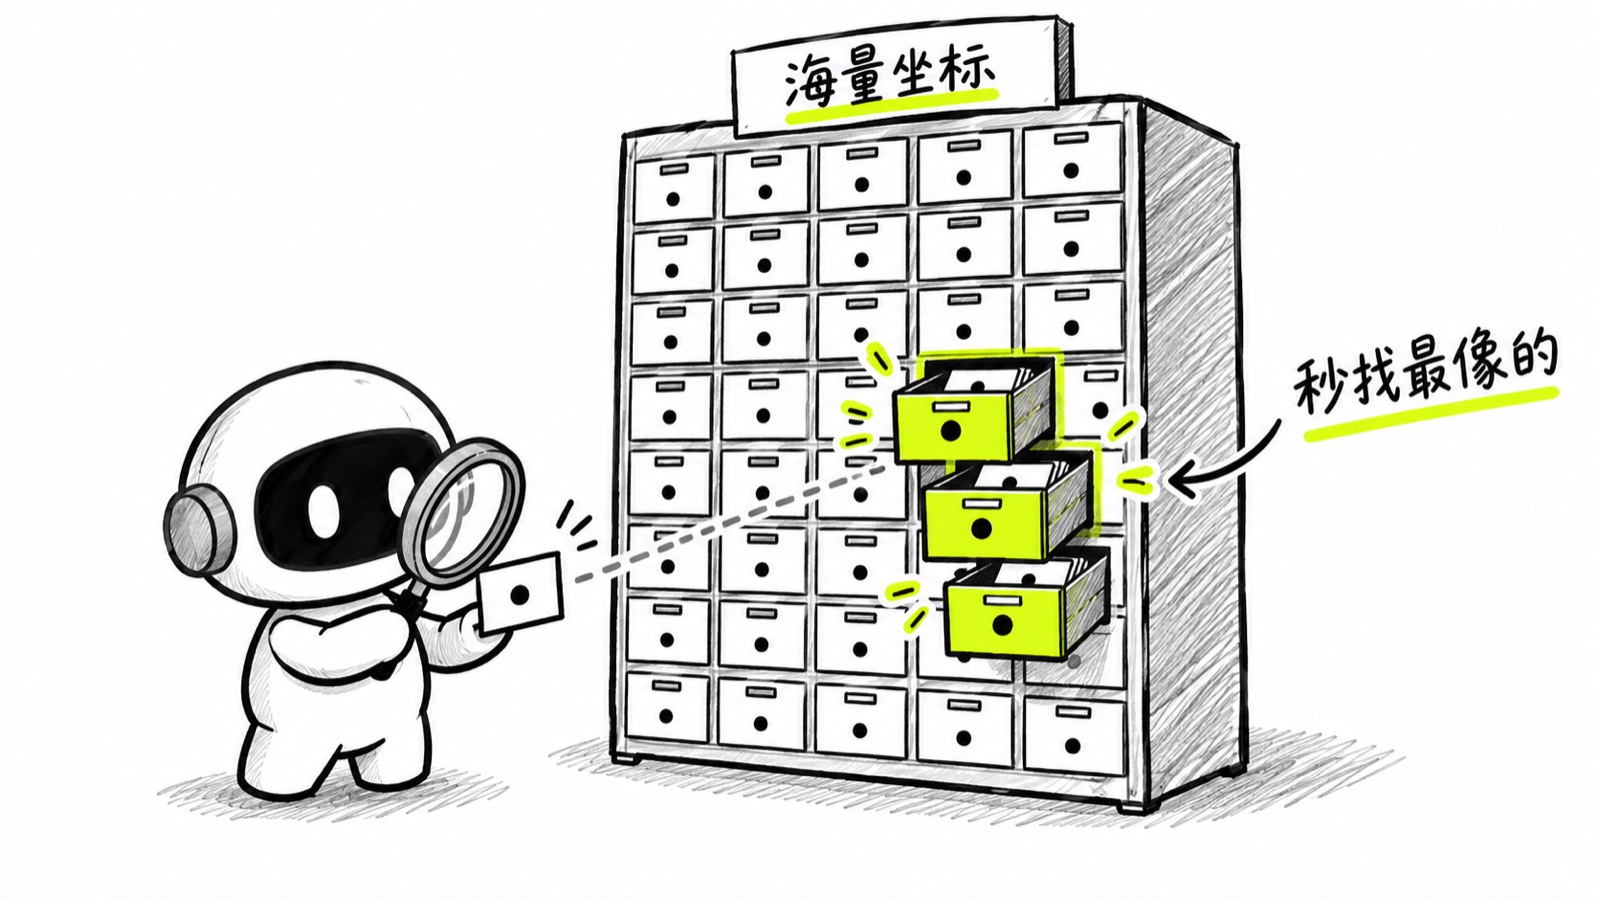
- 说人话
- 专门存放文字向量化之后那串数字的仓库,本事只有一个:你递进去一串数字,它很快找出库里最接近的几条。普通数据库擅长精确匹配,回答不了「最像」这种问题;几百万条一条条算距离又太慢,所以它另建一套索引,用放弃一点准确度换速度。搭知识库时它就是被查的那一层。
- 说行话
- 检索方式的行话叫 ANN(近似最近邻),配置里让你选的索引类型 HNSW、IVF 就是它的具体实现。库里存的不只是那串数字,原文通常一起存着,检索命中之后返回的是原文。
- 潜台词
- 「我们上了向量数据库」,通常是在原有数据库旁边加了一个组件,不是把业务数据搬了家。
- 别用它
- 几千条以内不需要。上了反而多一层运维。
拿这个能做什么4 个项目
- 01
- 02
- 03
- 04
已经有 Postgres 的,先上 pgvector,别多引一套系统。这个建议能省掉大半团队的运维成本,但几乎没有向量数据库厂商会这么告诉你。
动手试试做完就算会了
Embedding 那步的块连同向量 add 进 chromadb,提问也用 BGE 编码,跑 query(query_embeddings=q, n_results=3),看 distances 最小的对不对。改传 query_texts,它换用自带英文模型,当场报维度 512 对不上 384。