数据集
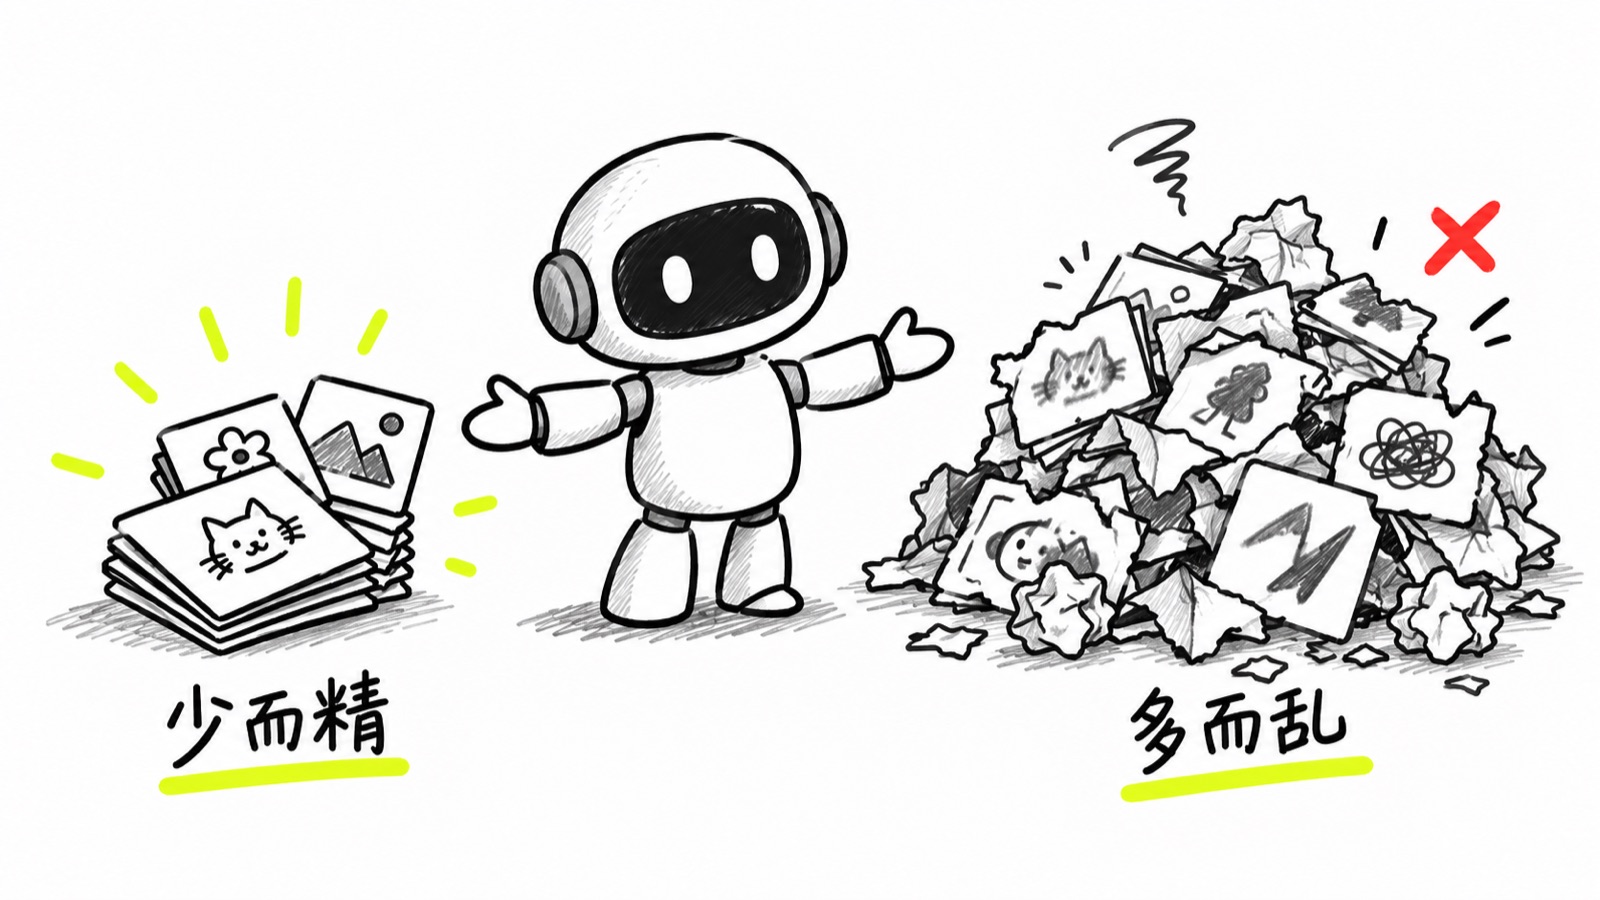
- 说人话
- 喂给模型学的那批例子,每条都是成对的:碰到这样的输入,就该给出这样的输出,还要统一成模型认得的格式。模型学的是这批例子的共性,包括你没打算教的那部分:例子普遍写得短,它往后就答得短;三条例子口径不一致,它就学得摇摆。所以真正的活儿是把历史工单、聊天记录一条条改干净。
- 说行话
- 通行格式是 jsonl,一行一条,字段要么是 messages 对话数组,要么是 Alpaca 那套 instruction、input、output。还要切一份不参与训练的验证集(validation),用来看有没有过拟合。
- 潜台词
- 「我们准备了一万条数据」。一百条精挑的通常比一万条脏数据强。
- 别用它
- 别用模型自己生成的数据反复训自己,会退化。
拿这个能做什么2 个项目
- 01
- 02
微调失败的复盘里,九成问题出在数据,不在超参。但调超参有仪表盘可看,洗数据只有枯燥,所以大家又都在做前者。
动手试试做完就算会了
用 transformers 加载微调那步模型的分词器,把「你是谁」当 user 消息传给 apply_chat_template(tokenize=False),开头多出 You are Qwen, created by Alibaba Cloud。你没写 system,模板替你补了,训练时每条都顶着它。