Token
- 说人话
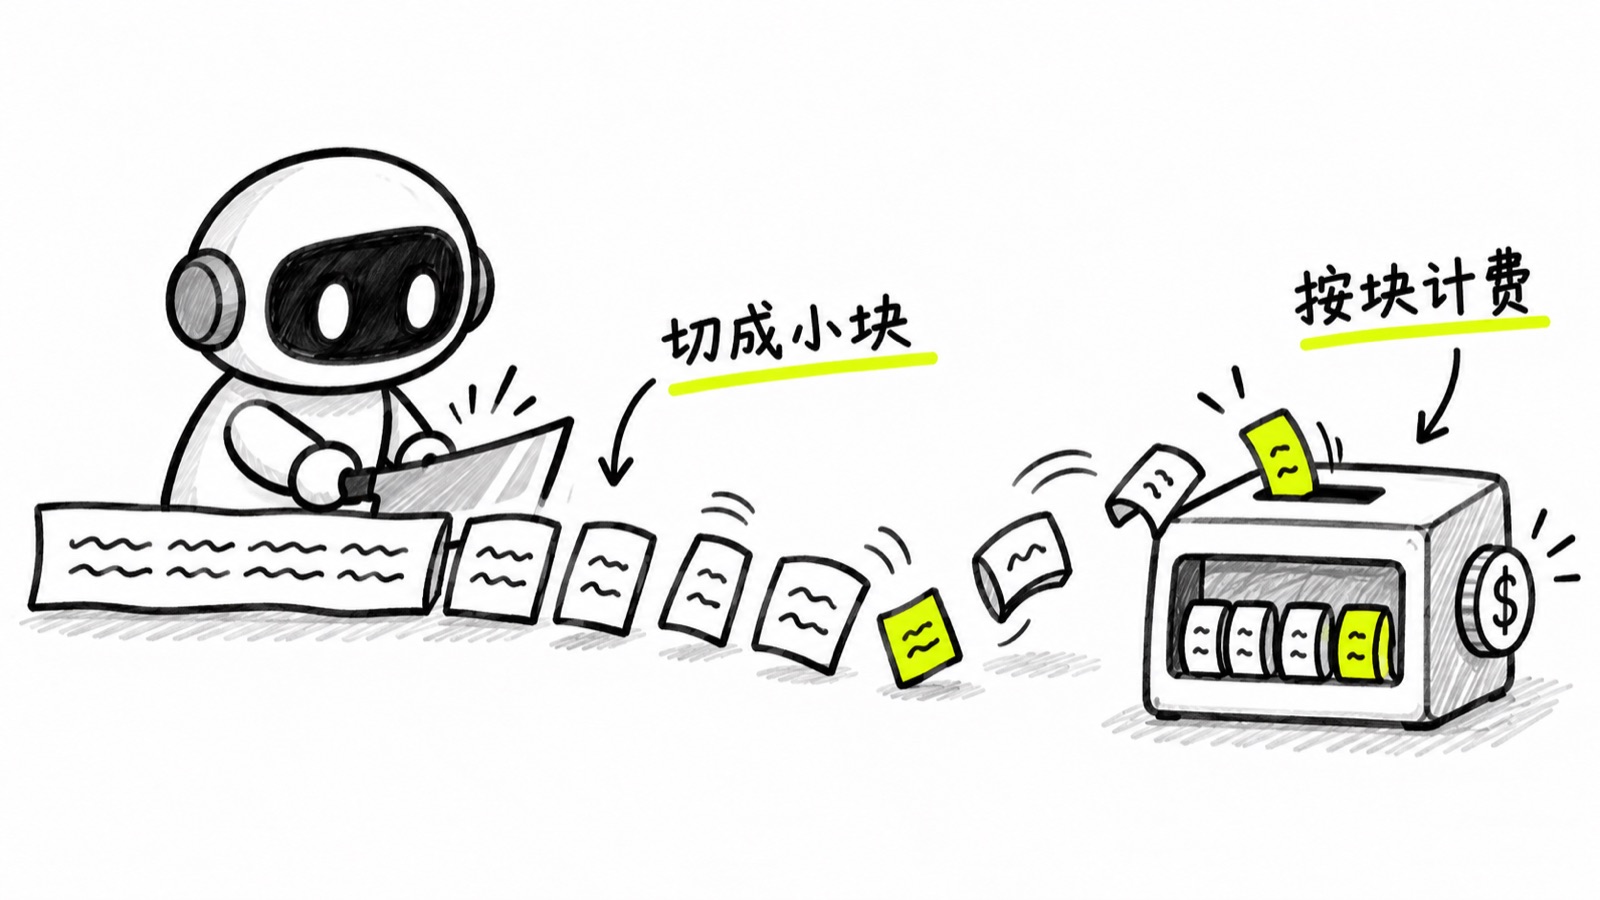
- 模型不按字读,也不按词读,它读的是一串事先切好的小块。这套切法是训练前统计出来的,常用的词整块算一个,生僻字和长英文单词会被拆成好几块,所以同一句话切出来的块数并不等于字数。模型每次只往外吐一块,你看到回答一小截一小截往外冒,就是这个过程。
- 说行话
- 分词器切出来的基本单元,英文叫 tokenizer。账单上的用量、模型页写的 128K、报错里的 max_tokens,说的都是它。按现在主流模型的分词器实测,1000 token 大约装得下 1300 个汉字。
- 潜台词
- 「这个月账单怎么涨这么多」,多半不是问题问得更多了,而是每次请求都把整段历史对话重发一遍,同一批字被反复计费。
- 别用它
- 不要拿字数直接换算成本。同一句话中文切出来的块数比英文多三成左右,照搬英文场景的经验值会低估。
拿这个能做什么2 个项目
- 01
- 02
同一段意思,中文用掉的 token 比英文多,但差距在缩小:老一代分词器上接近两倍,现在实测只多三成。成本仍然要拿自己的语料实测一遍,别照抄别人的估算。
动手试试做完就算会了
装 tiktoken,把你自己写的一段中文丢给 encoding_for_model("gpt-4o") 数一数块数,再换成同义的英文数一次。你会看到中文多出三成左右,这个数拿自己的语料算,别抄别人的。