Embedding
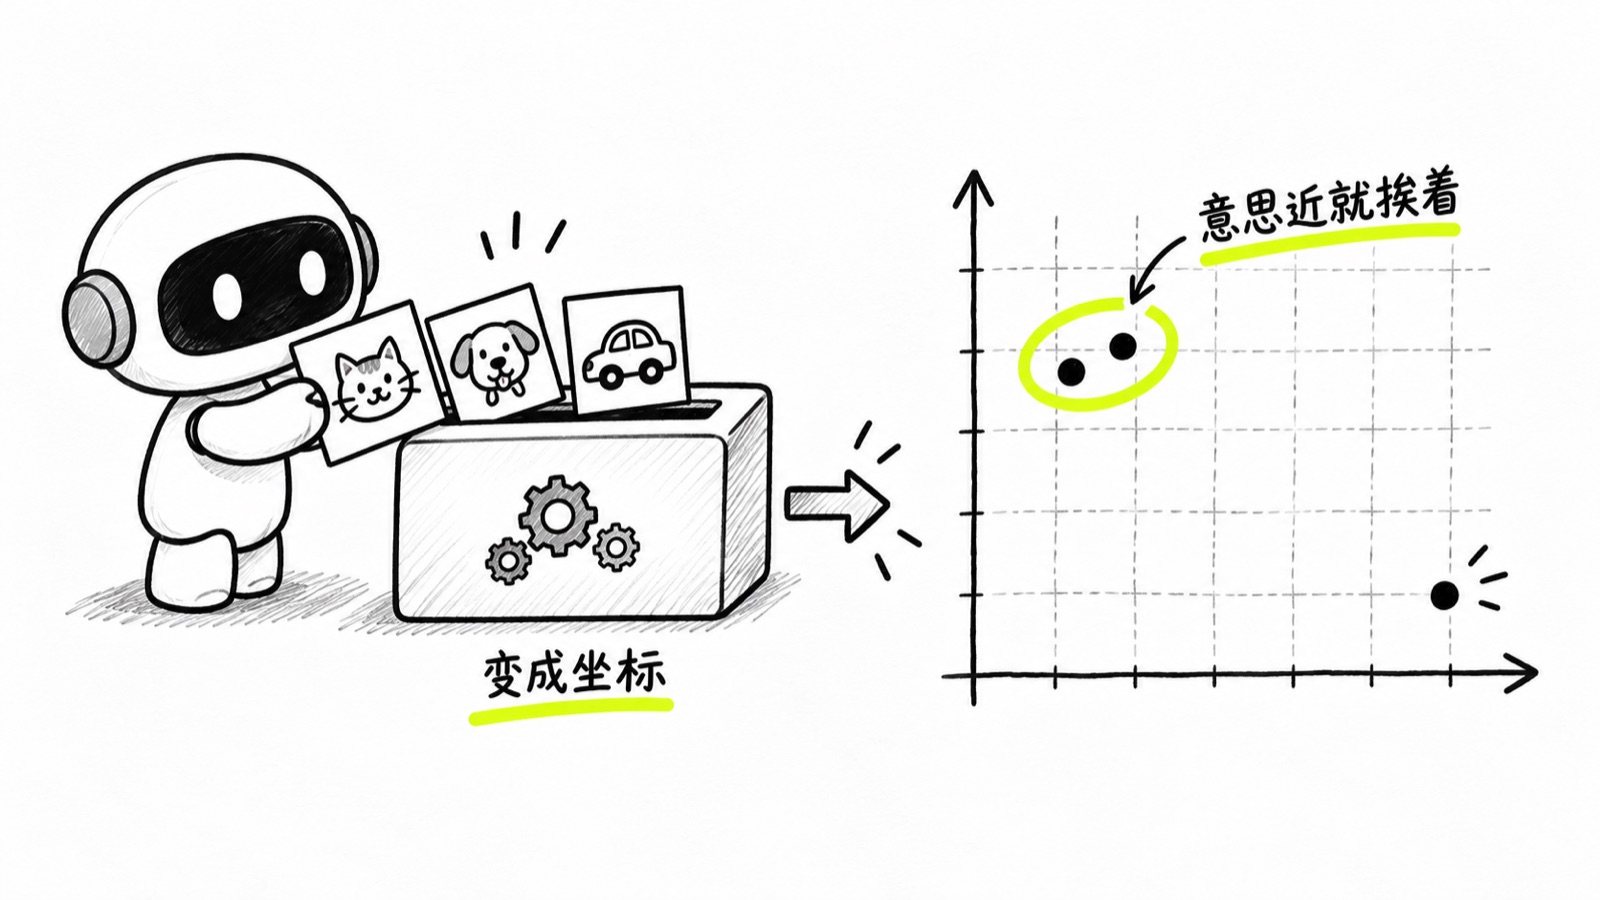
- 说人话
- 把一段文字交给一个专门的小模型,换回一长串数字,相当于给这句话在一个大坐标系里定了个位。位置是按意思排的,说同一件事的两段话就挨得近,于是「像不像」变成了「离多远」这种算得出来的事。所以你搜怎么退款,能命中写着订单取消后钱什么时候回来的那一条。
- 说行话
- 做这件事的模型叫嵌入模型(embedding model),和回答问题的那个模型是两码事,通常单独选、单独计费。一段文字换出来的数字有几百到几千个,这个长度叫维度。
- 潜台词
- 「我们做了语义搜索」,落到实处通常就是调一个嵌入接口把文字转成数字,再算一次距离,没有更多。
- 别用它
- 别当成万能的语义尺子。跨语言、跨领域时相似度会失真;而且换一个嵌入模型,整库的数字全部作废,必须重新算一遍再入库。
拿这个能做什么3 个项目
- 01
- 02
- 03
中文场景别默认用国外模型的通用向量。先去 MTEB 中文榜看排名,再看厂商宣传,这两者经常对不上。
动手试试做完就算会了
用 sentence-transformers 加载 BAAI/bge-small-zh-v1.5,把分块那步切好的块 encode 一遍,.shape 会显示每块不论长短都是 512 个数。再看 max_seq_length,上限 512 个 token,超出的尾巴被悄悄截掉,不报错。