多模态
- 说人话
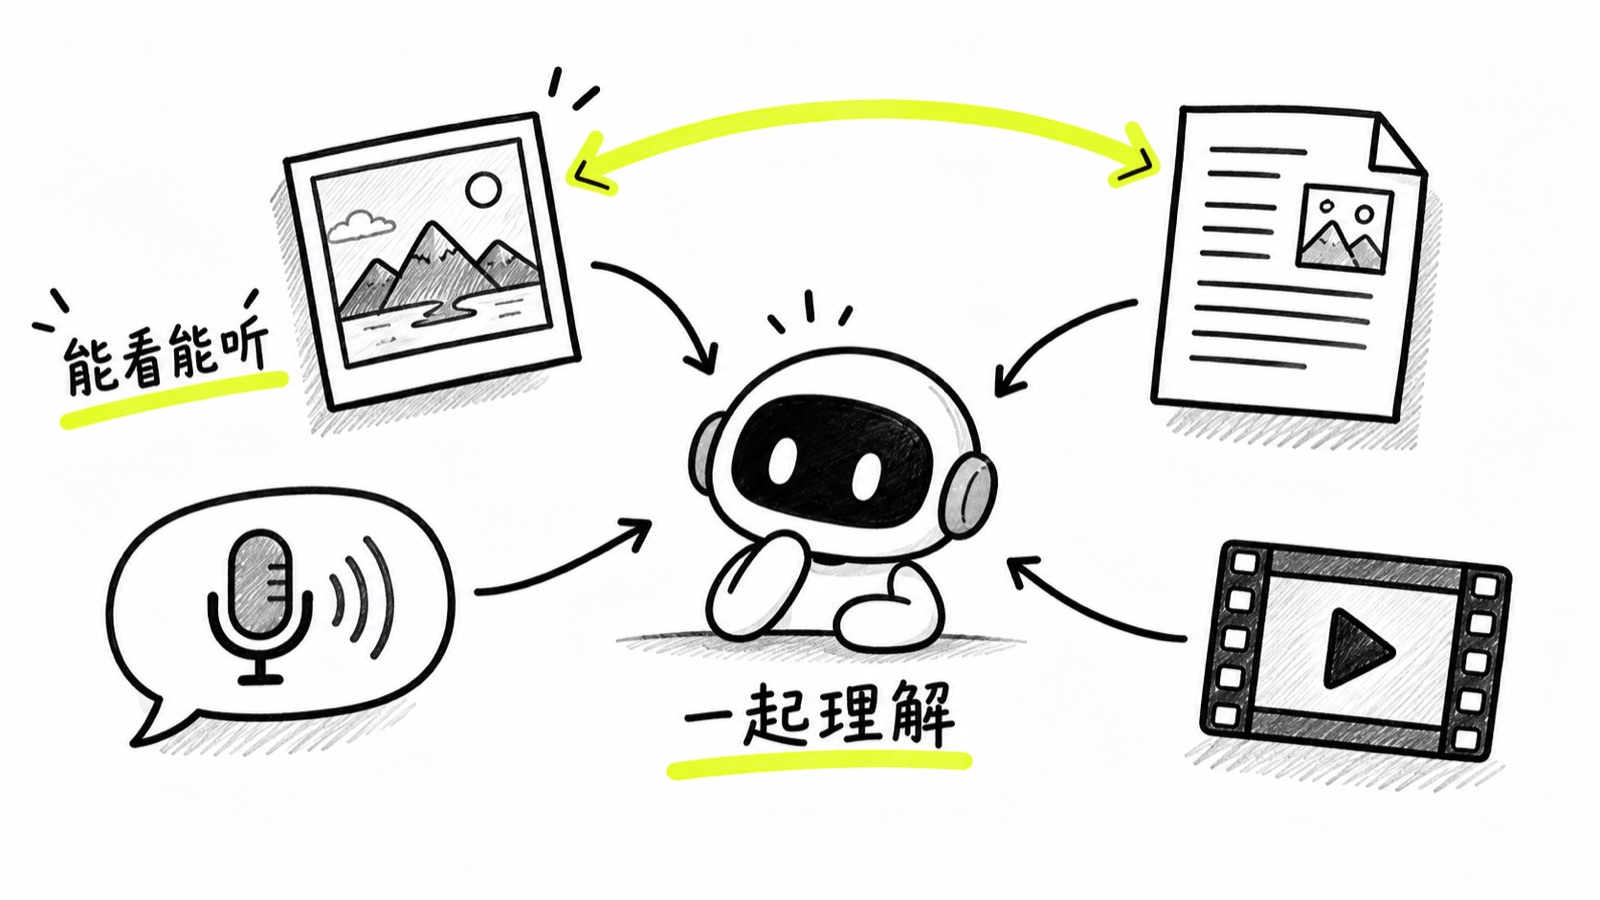
- 除了文字,还能直接吃图片、声音、视频的模型,有的也能反过来产出这些。它内部只认一串数字,所以图片会被切成一小块一小块、声音切成一小段一小段,转成和文字同一种形式排在一起送进去,它才能对着图讲话。日常碰到的就是:截图丢给它问这个报错什么意思,拍张冰箱问晚饭做什么。
- 说行话
- 只处理图和文的那一类叫 VLM(视觉语言模型)。接口上的体现是 content 从一段文字变成数组,text 之外还能放 image_url;图片同样按 token 计价,一张常折算成几百到上千 token。
- 潜台词
- 「支持多模态」多数时候只是能看图,不一定能听、能说,更不一定能生成图片。
- 别用它
- 别把「能看图」当成「看得准」。读小字、数物件、判断空间位置仍是它的常见失误;要精确提取表格和文字,先上专门的 OCR。
拿这个能做什么4 个项目
- 01
- 02
- 03
- 04
多模态有两种做法:给语言模型外挂一个看图模块,或者从训练起就把各种模态混在一起的原生多模态。实时语音对话这类场景,后者省掉了转文字再转回语音的环节,体验差距明显。选型时先问清是哪一种。
动手试试做完就算会了
sips -Z 200 a.png -o s.png 缩一张小图给 ollama run qwen3-vl:2b-instruct --verbose "描述 ./s.png",prompt eval count 一千出头;缩到 1920 再给,两千多。Ollama 给千问看图定了 1024 token 的底。