LoRA
- 说人话
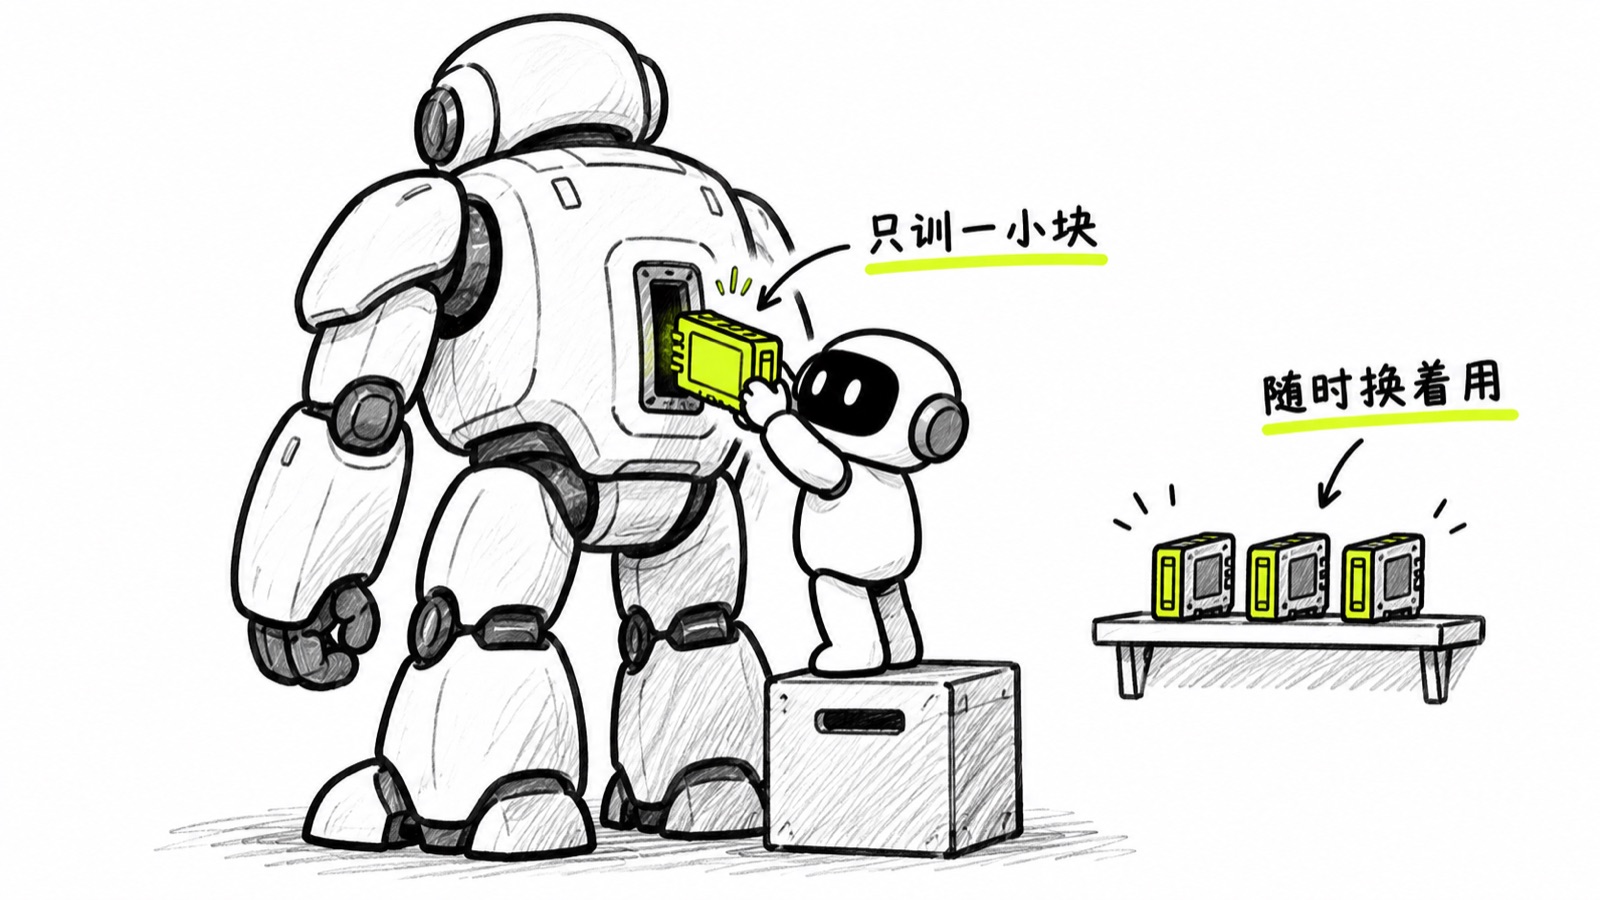
- 微调的省钱版。全量微调要把模型里每个数字都改一遍,训练途中还得额外存下一整套中间状态,显存立刻就爆;LoRA 把原模型整个锁死不碰,只在旁边挂一小块新参数参与训练,靠这一小块去偏转原来的输出。所以一张消费级显卡就训得动,个人也能训出自己那一版。
- 说行话
- 全称 Low-Rank Adaptation。训练配置里要填两个数:秩 r 决定新增的那块有多大,常见取 8 到 64;lora_alpha 决定它对原输出的影响强度。产物是一个 adapter 文件,和基座模型分开加载。
- 潜台词
- 现在说微调基本都是这个,全参训练个人玩不起。
- 别用它
- 目标任务和原模型差太远时,低秩不够用。
拿这个能做什么2 个项目
- 01
- 02
LoRA 产出的是一个几十兆的补丁,不是一个新模型。可以同时挂多个、随时切换,这个特性比省显存更被低估。
动手试试做完就算会了
给微调那步的模型套上 peft 的 LoraConfig(r=8),装好后调 print_trainable_parameters(),trainable% 是 0.1093,只挂了 q_proj 和 v_proj。那步训练日志里这行是 0.8826,默认七类线性层全挂:同叫 LoRA,改动量差八倍。