记忆
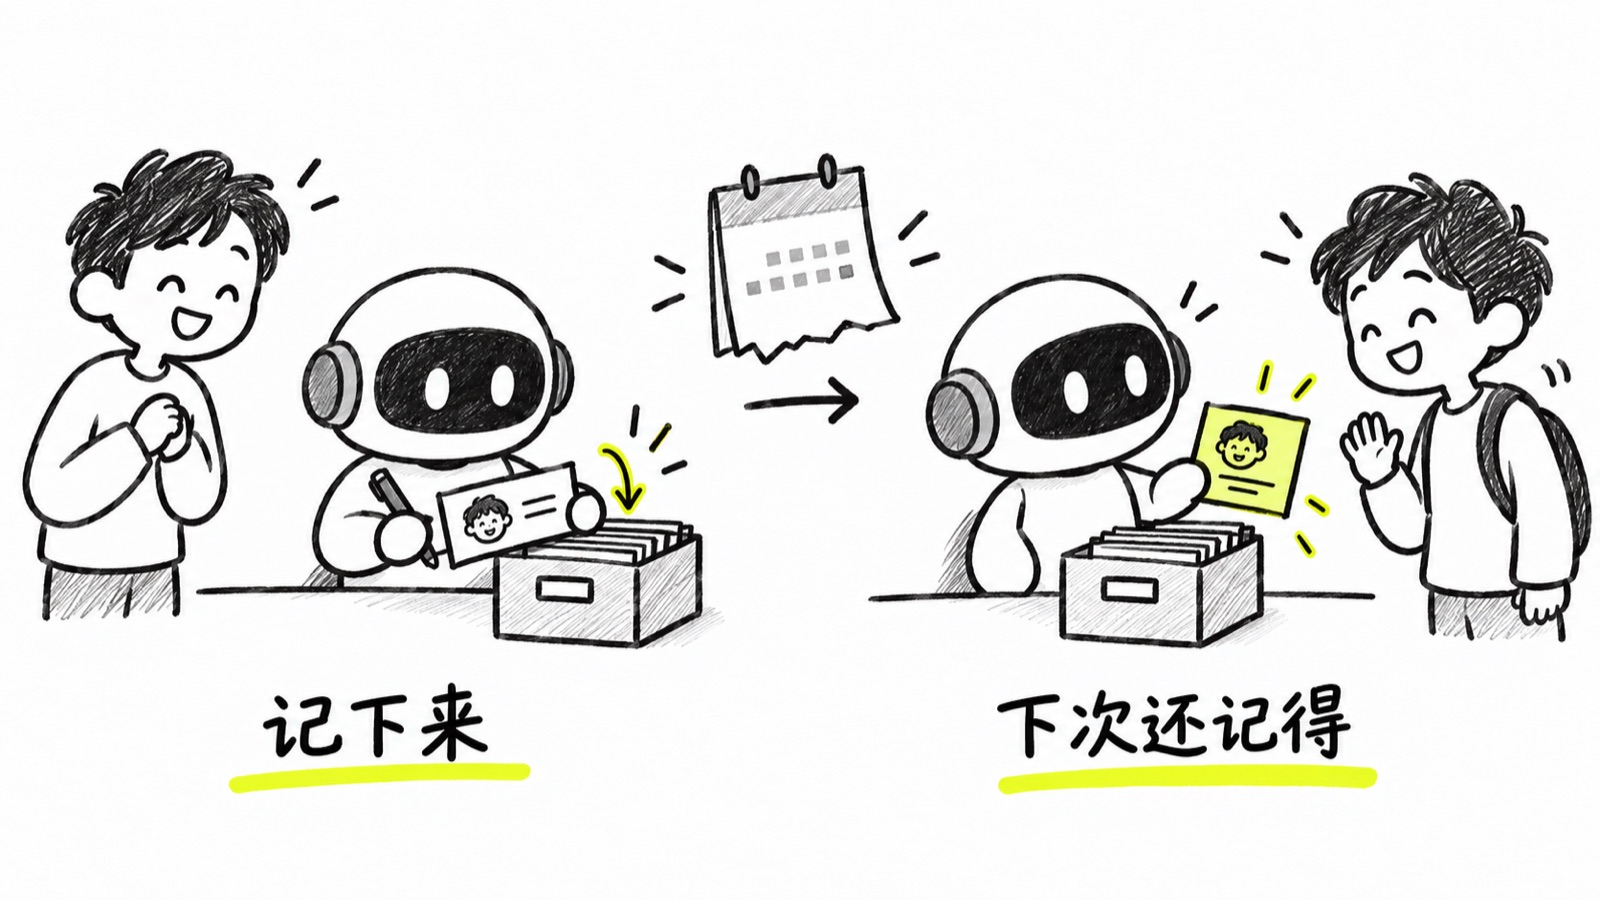
- 说人话
- 模型每开一个新对话都是从零开始,上回说过的习惯、项目背景、你叫什么,全都不在了。把全部聊天记录都带上又不现实,窗口装不下,也烧钱,于是只把关于你的那几条挑出来单独存着,下次用得上再拿回去。你看到的现象是聊着聊着冒出一行已更新记忆。
- 说行话
- 行话分短期(会话内)与长期(跨会话),这里说的是后者。关键动作叫 fact extraction,把对话抽成一条条独立事实再存;设置里那个 Memory 面板列出来的就是这些条目,可以逐条删。
- 潜台词
- 「它能记住我」,底层通常是一个带检索的外部存储,不是模型真的记住了。
- 别用它
- 一次性问答不需要。记下来的东西会过期也会记错,一条错的偏好能跟着你很多轮,所以一定要留出让人查看和删除的入口。
拿这个能做什么3 个项目
- 01
- 02
- 03
记忆和 RAG 的边界很容易混:RAG 取的是文档,记忆取的是关于用户的事实。前者答「资料里怎么说」,后者答「他上次说过什么」。
动手试试做完就算会了
mem0ai 的 llm、embedder 都选 ollama,前者填 qwen2.5:1.5b,embedding_model_dims 改 768。同一 user_id 先后 add「只喝美式」「改喝拿铁了」,两次 event 都是 ADD,get_all 两条并排,谁作数你来裁。