上下文窗口
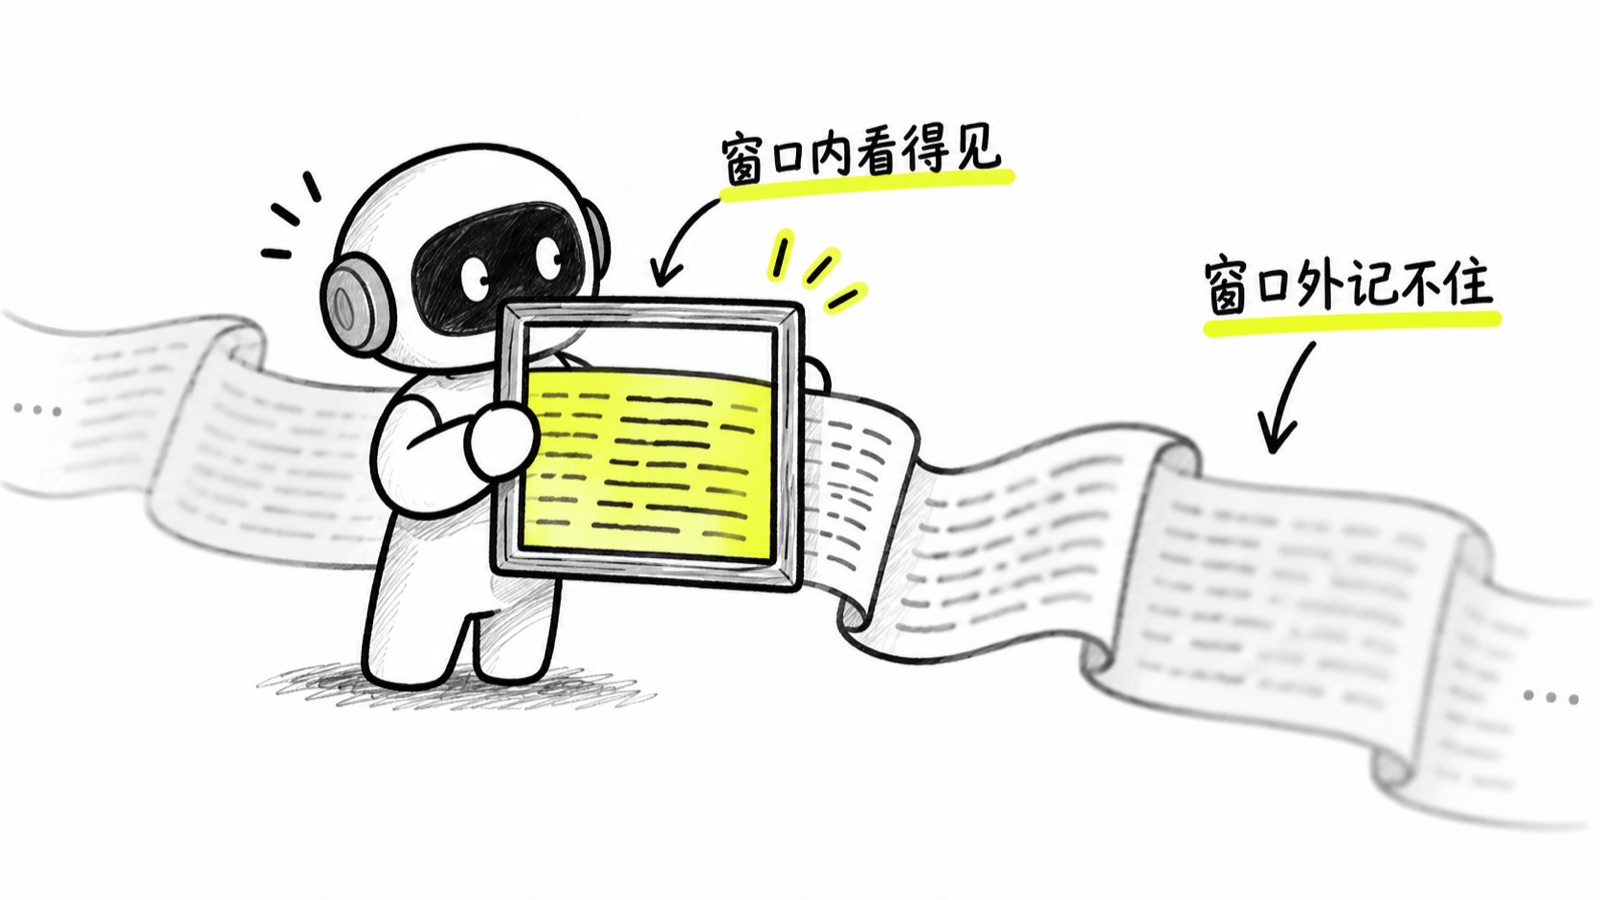
- 说人话
- 模型没有记忆,你每问一次,整段对话都要从头重新读一遍,窗口就是这一次能读进去的量,输入和输出共用这个额度。超出之后最早的那部分会被悄悄丢掉,你看到的现象就是它突然忘了开头交代过的规矩。常听到的 128K,说的就是这个额度有多大。
- 说行话
- 英文 Context Window。产品里超出会自动丢掉旧内容,自己调 API 则直接报错,常见字样是 context_length_exceeded。模型页写的 128K 这个额度,按现在主流模型的分词器约合十六万汉字。
- 潜台词
- 听到「上下文不够用了」,多半是塞了太多没用的历史对话。
- 别用它
- 不是越大越好。塞满会让模型抓不住重点,也更贵更慢。
拿这个能做什么3 个项目
- 01
- 02
- 03
上下文不够用有三条路:压缩(把话说短)、检索(用时再取)、记忆(跨会话留存)。大部分人只知道第二条,于是什么都往 RAG 上怼。
动手试试做完就算会了
ollama show qwen2.5:1.5b 写着 context length 32768,对话开着时再跑 ollama ps,CONTEXT 那列多半只有 4096。显存不到 24GB 时 Ollama 默认就开这么大,敲 /set parameter num_ctx 32768 才用得满。