MoE
- 说人话
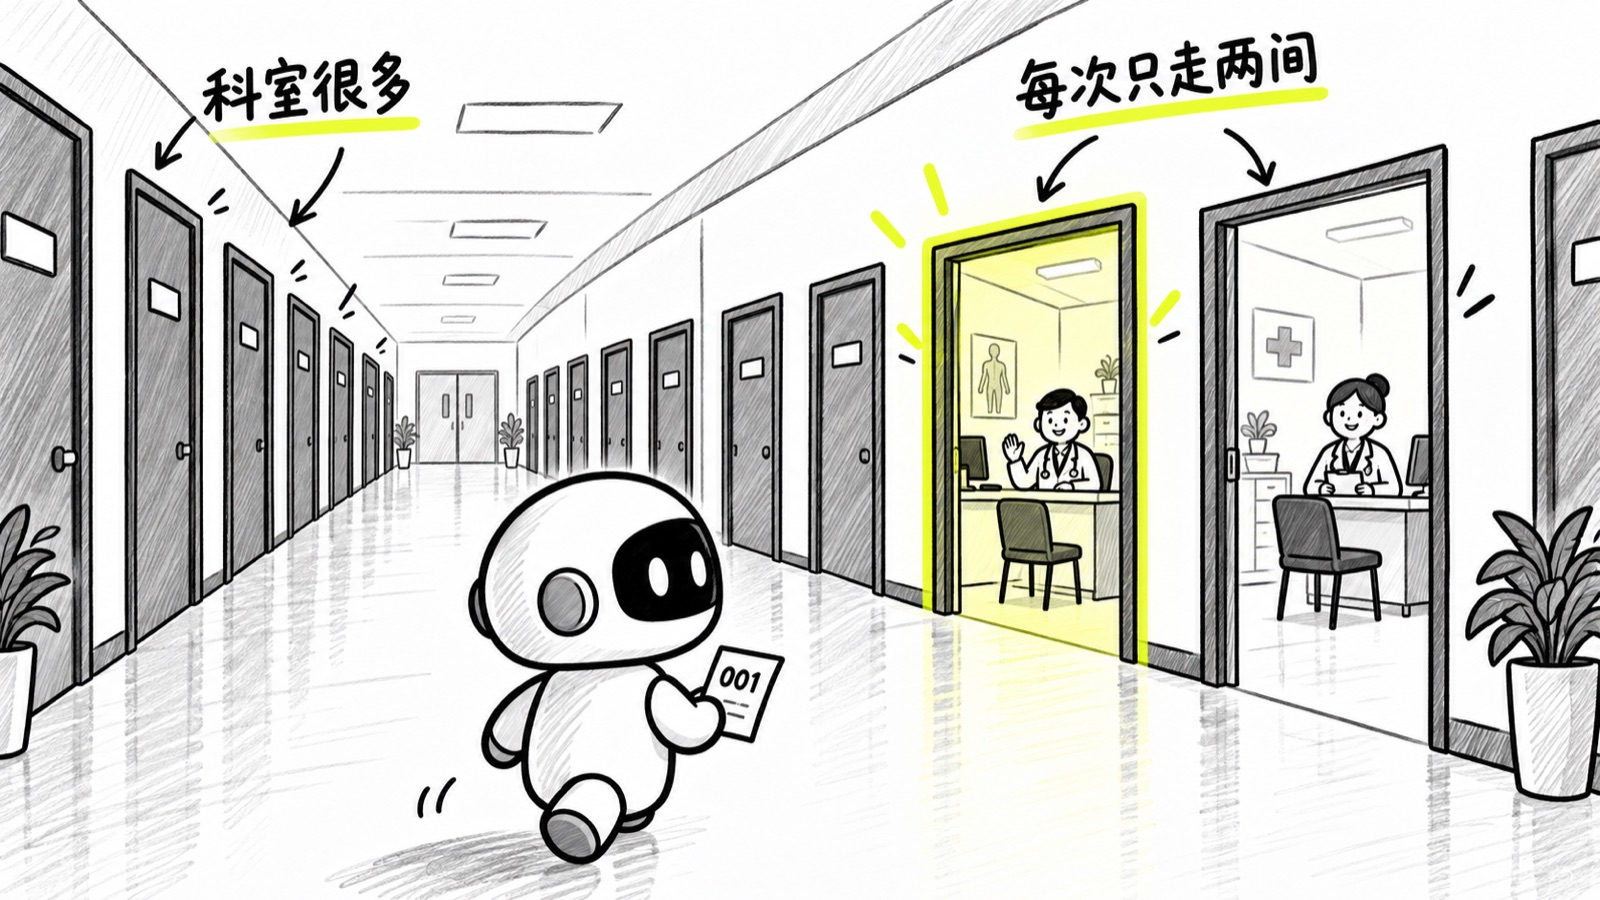
- 一个几千亿参数的模型,回答你这一句话时并不会全体上工。MoE 把网络切成很多小块,每处理一个字只挑其中几块来算,其余的闲着。所以你会看到「总参数 6710 亿、激活 370 亿」这种写法,前一个数决定它装得下多少东西,后一个数决定它算起来多快多便宜。
- 说行话
- 全称 Mixture of Experts。模型名里的 A3B、A22B 这类后缀说的就是激活参数量,A 取自 activated;决定每个 token 走哪几块的部件叫路由器(router),一次选几块写成 top-k。
- 潜台词
- 「我们的模型有几千亿参数」,如果是 MoE,每次真正干活的只是其中一小部分,和同等总参数的稠密模型不是一回事。
- 别用它
- 别拿总参数量直接比强弱。MoE 的显存按总参数算,速度和价格按激活参数算,这两个数要分开看。
拿这个能做什么2 个项目
- 01
- 02
MoE 换来的是同一笔算力下把模型做得更大,代价是显存要装下全部专家。这也是很多开源大模型你下得动却跑不动的原因:卡在显存,不在算力。
动手试试做完就算会了
打开 Hugging Face 里 Qwen/Qwen3-30B-A3B 的 config.json,num_experts 128,num_experts_per_tok 8,每个 token 只走十六分之一。模型卡的激活比却是 3.3B 比 30.5B,一成出头:注意力层和词表人人都过,不分专家。