幻觉
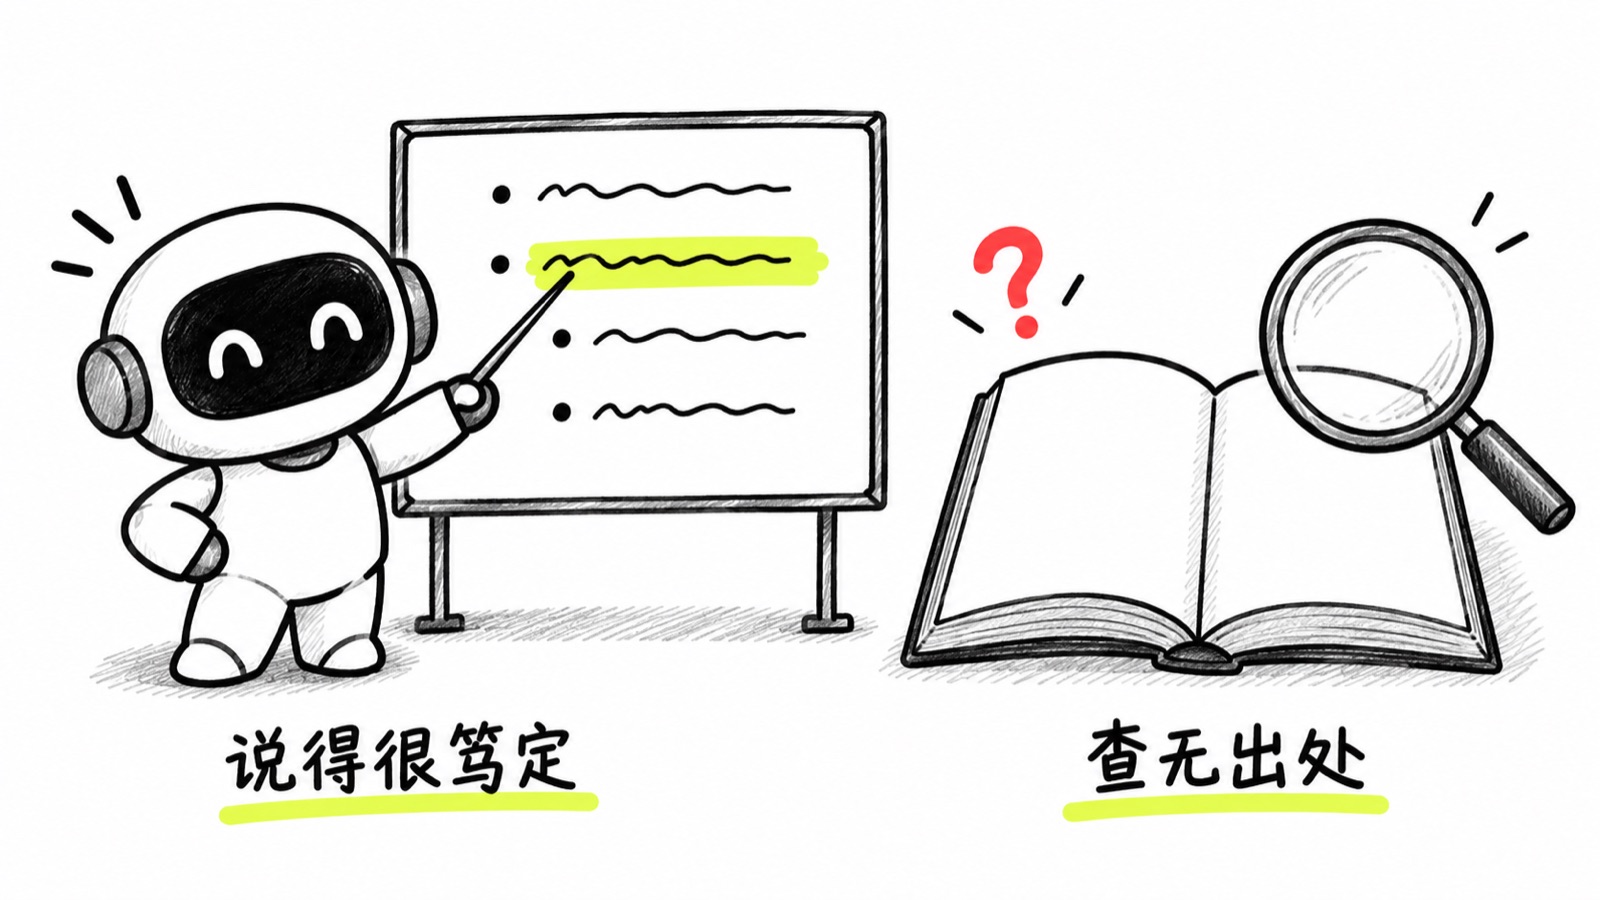
- 说人话
- 模型不是在查资料,它是在算下一个字最可能是什么。碰到没学过、你也没给它的内容,它不会停下来说不知道,而是顺着语感把话接完整,编出格式完全正确的论文标题、接口参数、法条编号。越是冷门领域,编得越顺口。
- 说行话
- 评测报告里对应的两列指标叫 faithfulness(忠实度,答案有没有超出给的材料)和 groundedness(每句话能不能指回原文某一段),Ragas、DeepEval 这类工具算的就是它们。
- 潜台词
- 「它胡说八道」。多数情况下是上下文里根本没有答案,模型不肯说不知道。
- 别用它
- 不是资料给得越多,幻觉就越少。塞进去的材料一旦杂乱、互相矛盾,它反而更容易拼出一个看似合理的答案。
拿这个能做什么2 个项目
- 01
- 02
治幻觉的前提是能量化。没有评测集就调提示词,等于蒙眼开车,改完只能靠感觉说「好像好点了」。
动手试试做完就算会了
问本地的 qwen2.5:1.5b:列出五篇讲检索增强生成的论文,附 arXiv 编号。把编号逐个接在 arxiv.org/abs/ 后面打开,多半对不上,要么是另一篇不相干的论文,要么直接 Article not found。记下五个里中了几个,以后换模型、改提示词都拿同一问重测。