Benchmark
- 说人话
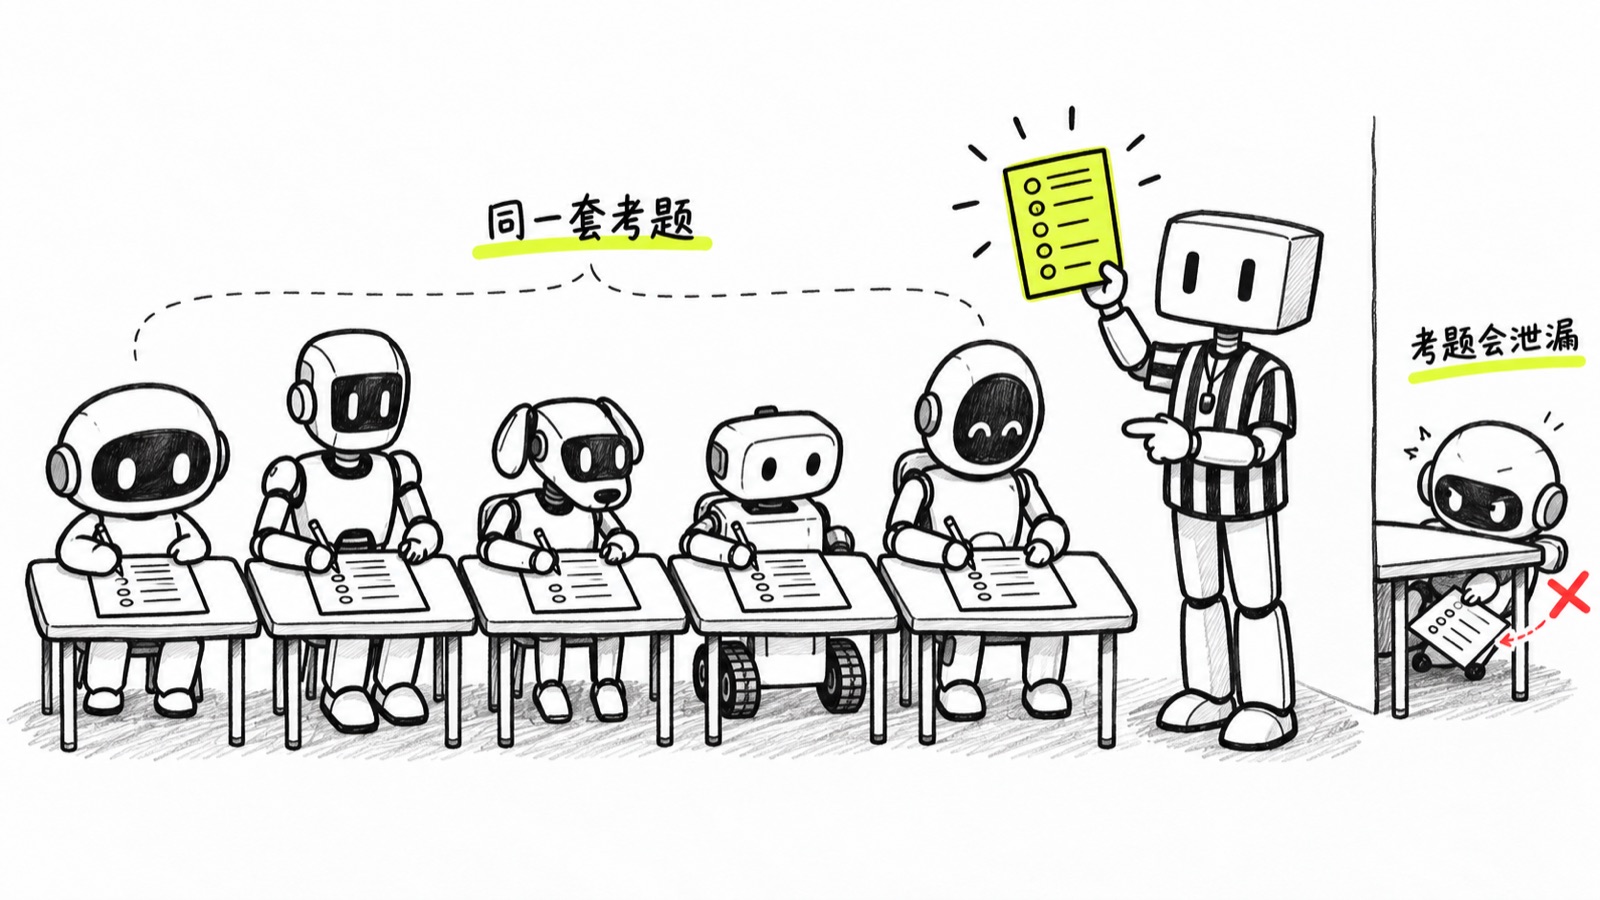
- 每家都说自己更强,没有同一份卷子就没法比。于是有人把题目和判分规则一起固定下来,所有模型做同一套题,分数才能横着摆在一起看。有标准答案的题机器自动对,没有标准答案的就请人,或者另外找一个模型来打分。你在模型发布页上看到的一串英文缩写加百分数,就是它的成绩单。
- 说行话
- 发布页上那排缩写各有分工:MMLU 考知识面,GSM8K 考小学数学,SWE-bench 考能不能改真实代码。看分先看小字:0-shot 还是 5-shot、pass@1 还是 pass@k,条件不同就不能摆在一起比。
- 潜台词
- 「在某某榜上排第一」,要追问两件事:题目有没有泄漏进训练数据,这个榜是不是早就被刷到顶了。
- 别用它
- 公开榜单测的是通用能力,替代不了你自己业务的测试集。分数高出几分,放进你的场景里可能完全感受不到。
拿这个能做什么3 个项目
- 01
- 02
- 03
一个 Benchmark 出名之后,就会被针对着优化,分数于是越来越不代表真实能力。最值钱的评测集是你自己攒的:几十条真实用户问题配上标准答案,比任何公开榜单都更能决定该选哪个模型。
动手试试做完就算会了
inspect eval inspect_evals/gsm8k --model ollama/qwen2.5:1.5b --limit 20,先装 inspect-evals 和 openai。末尾 accuracy 旁的 stderr 多在 0.1 上下,乘二即正负二十个点:差五个点分不出谁强。