蒸馏
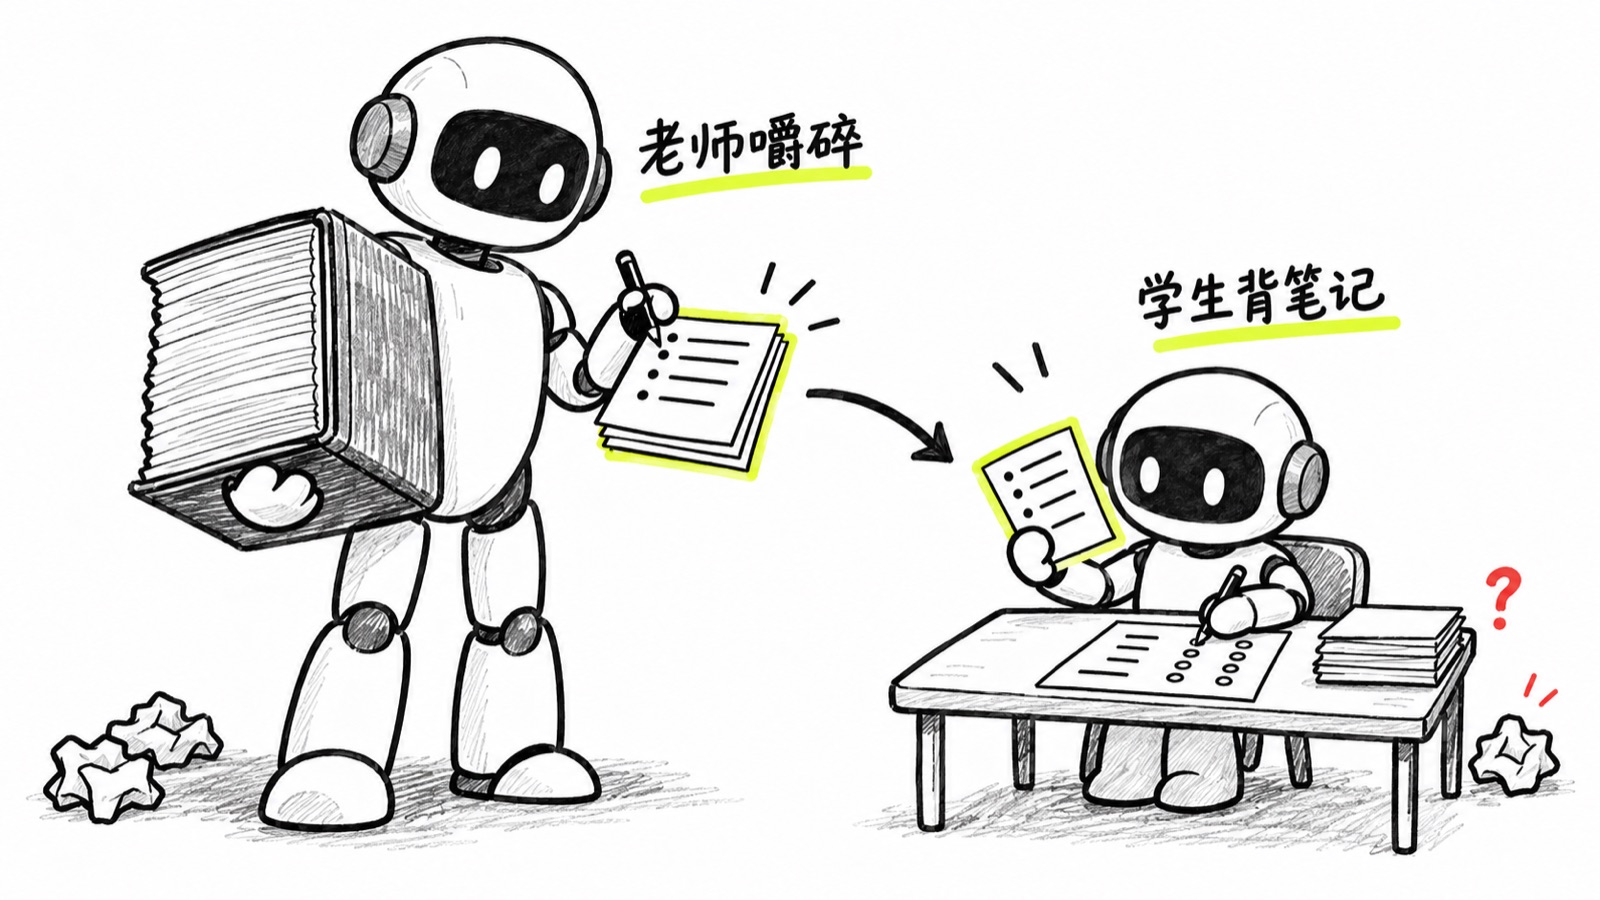
- 说人话
- 拿一个又大又贵的模型当老师,让它把一批问题先做一遍,再用它的答案去训练一个小模型。小模型学的不是原始资料,而是老师的作答方式,所以能用小得多的体量,在特定任务上接近老师的水平。能在手机和笔记本上跑的那些小模型,多半是这么来的。
- 说行话
- 英文 Knowledge Distillation。开源模型名里带 Distill 的那一批就是学生模型,比如 Distill-Qwen-7B。教师交出来的不只是答案,还有每个候选 token 的概率分布,行话叫 soft label。
- 潜台词
- 「小模型也有大模型的水平」,前提通常限定在某一类任务上,换个题型差距立刻回来。
- 别用它
- 想要一个什么都会的小模型,别指望蒸馏。它擅长把一件事做窄做精,不擅长保住通用能力。
拿这个能做什么3 个项目
- 01
- 02
- 03
蒸馏和微调常被混着说:微调是拿数据教,蒸馏是拿另一个模型教。门槛不在算法,在老师答得对不对,老师错了,学生会把错处学得一丝不差。
动手试试做完就算会了
ollama run deepseek-r1:1.5b 问一道应用题,它先自言自语一大段,LLM 那步的 qwen2.5:1.5b 没有这段。ollama show 两者,architecture 都是 qwen2,embedding length 都是 1536:名叫 DeepSeek,身子是 Qwen。