分块
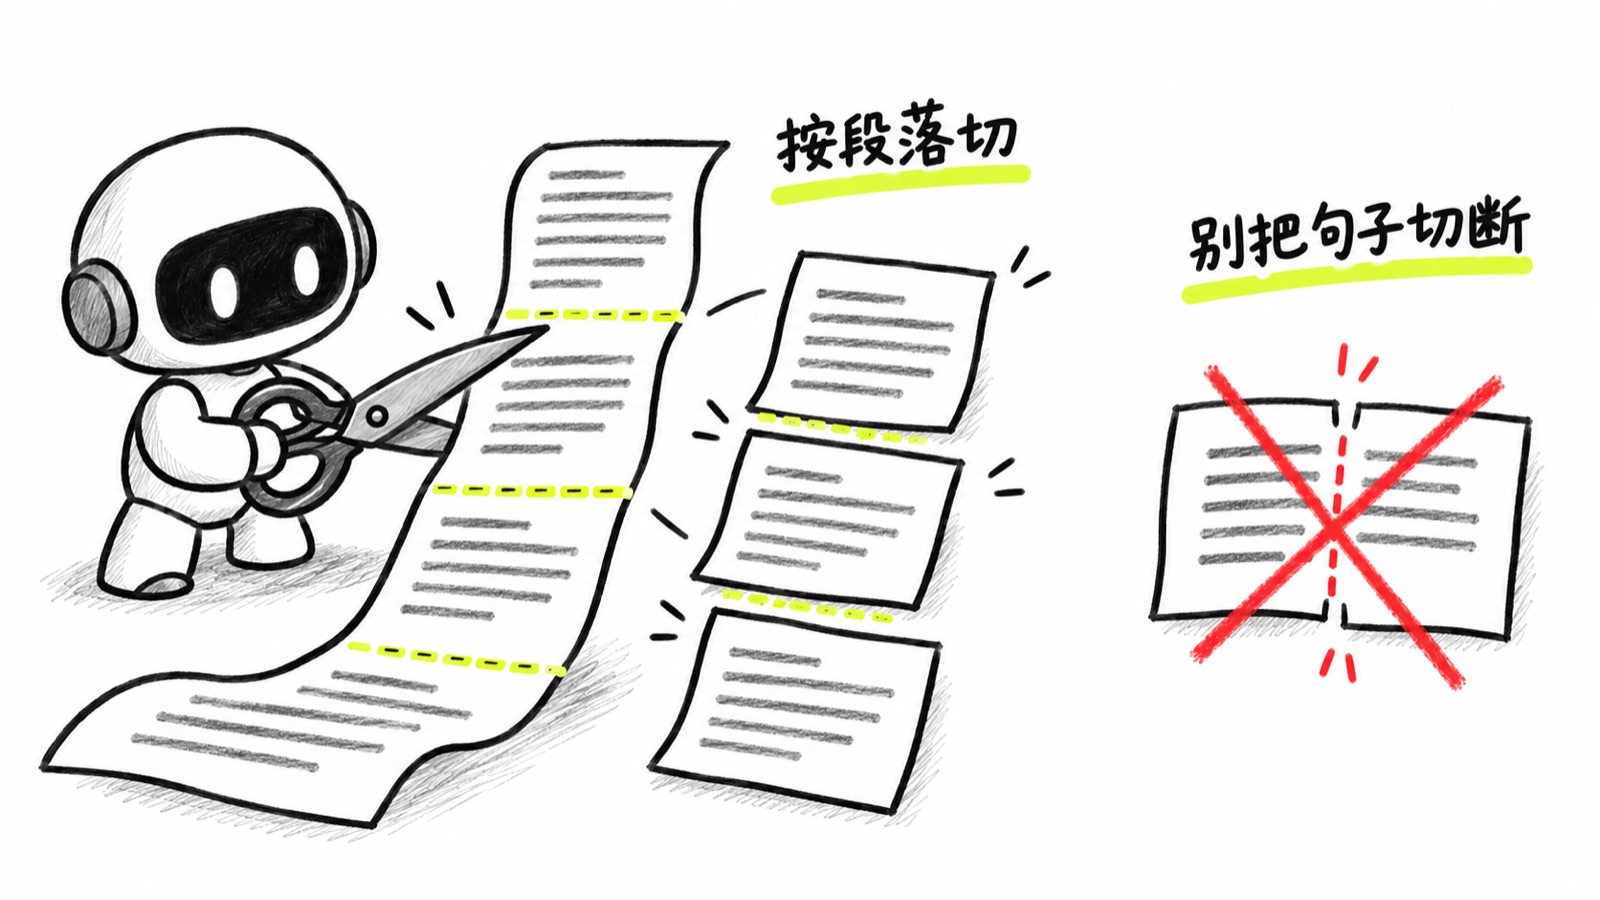
- 说人话
- 把长文档切成一段一段再入库的动作。为什么非切不可:检索是拿问题逐段比对的,整本书算作一段,十个话题糊成一团,比起来谁都像又谁都不像;而取回的段落还要塞进模型有限的上下文,太长根本放不下。你看到 AI 回答时引用的那种掐头去尾的片段,就是当初切出来的一段。
- 说行话
- 英文叫 chunking,切出来的每段叫 chunk。各家工具的配置里都有两个参数:chunk size 定每段多长,overlap(重叠)定相邻两段共享多少字,被切断的句子靠它在下一段补回来。
- 潜台词
- 很多人说 RAG 效果差,八成是切法有问题,不是模型不行。
- 别用它
- 不要机械按字数切,会把一句话腰斩,检索出来的片段读不通。
拿这个能做什么2 个项目
- 01
- 02
调 RAG 效果时,动分块策略的收益通常大于换模型。但前者要啃脏文档,后者改一行配置就能交差,所以大家都在做后者。
动手试试做完就算会了
装 chonkie[hub],中文长文档先用 RecursiveChunker(chunk_size=300) 切,再用 from_recipe(lang="zh", chunk_size=300) 切,各打印每块最后五个字。前者在长段落第 300 字处硬断,默认规则只认英文句点;后者基本收在「。」上。