RAG
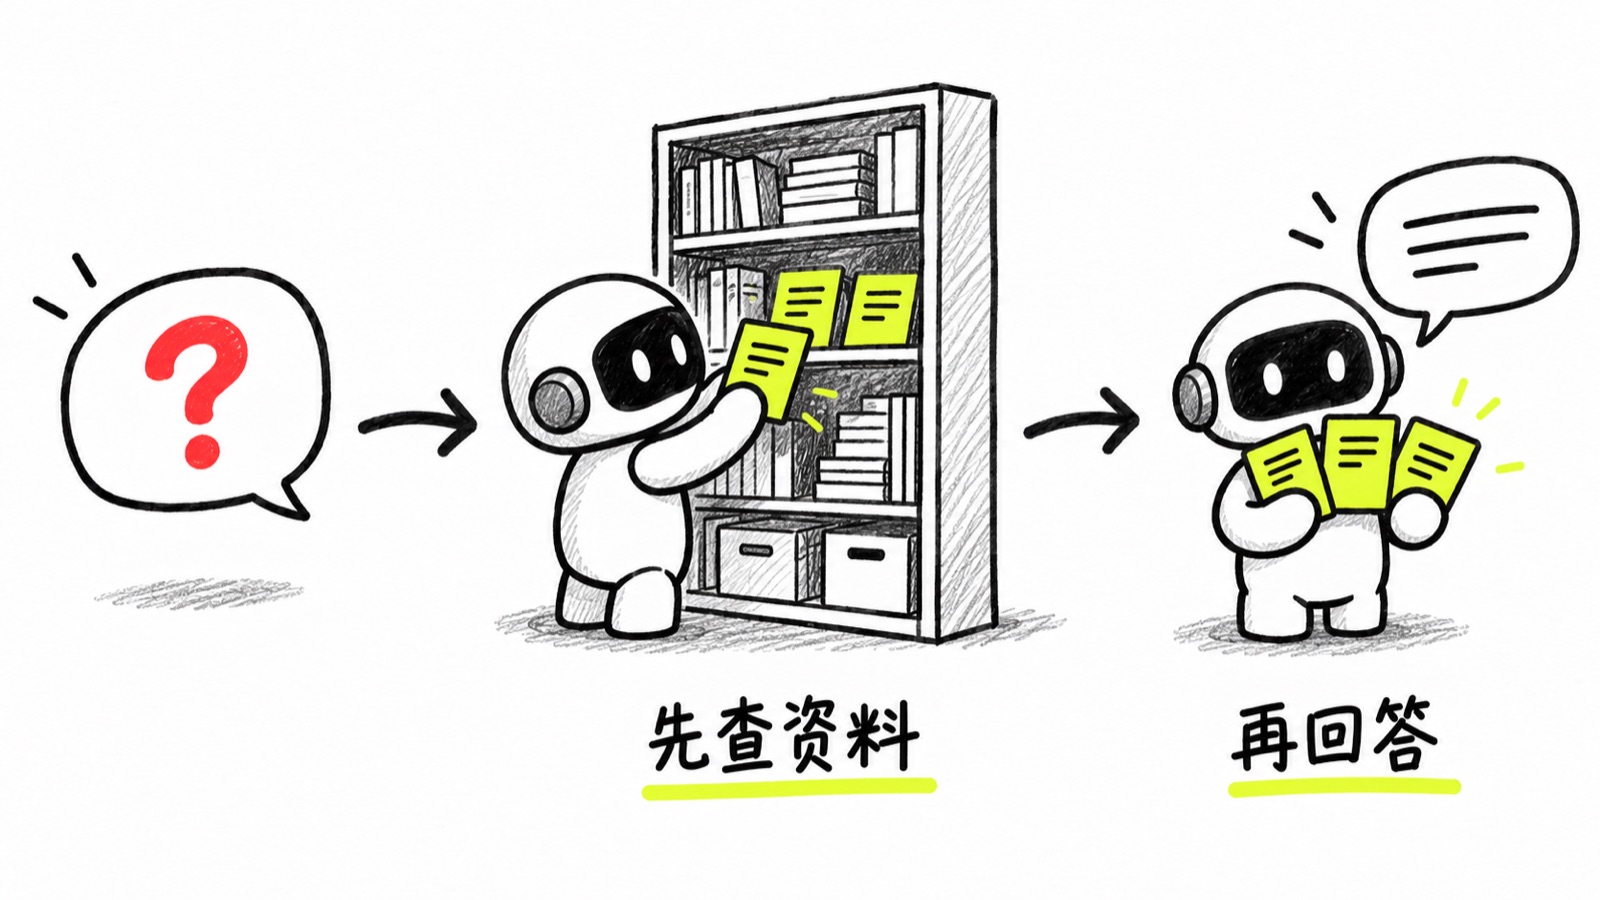
- 说人话
- 模型的知识停在训练结束那天,也没见过你公司的文档,直接问内部规章只会瞎编。这套做法是先拿问题去你自己的资料里搜一遍,把搜到的原文连同问题一起递给模型,让它照着眼前的材料回答。你见过的那种带引用角标的企业问答就是它,答错时多半是没搜到对的段落,而不是模型不懂。
- 说行话
- 全称 Retrieval-Augmented Generation,检索环节最常调的参数是 top_k,控制每次取回几段。几十页的资料直接塞进上下文更省事,上百份文档而且经常更新,才值得搭这一套。
- 潜台词
- 「我给它接了个知识库」。九成场景背后就是一次向量检索加一次拼接。
- 别用它
- 检索只能找到跟问题字面或意思相近的段落。要跨好几份文档综合、要按时间先后推演的问题,它常常搜不全,答案缺了一块你还看不出来。
拿这个能做什么4 个项目
- 01
- 02
- 03
- 04
选框架前先看自己卡在哪:卡在文档读不进来选 RAGFlow,卡在检索链路要自己调选 LlamaIndex,卡在非工程同事也要能改选 Dify。多数人的问题其实卡在第一步。
动手试试做完就算会了
在向量数据库那步的 chromadb 集合上出五道你知道答案在哪段的题,把 query 返回的 documents 三段拼在问题前,交给 qwen2.5:1.5b 作答。答错的逐题对照,记下两类各几题:正确段落没进来,回头改分段;进来了还答错,才动提示词或换模型。Dify 的召回测试只查得出前一类。