Transformer
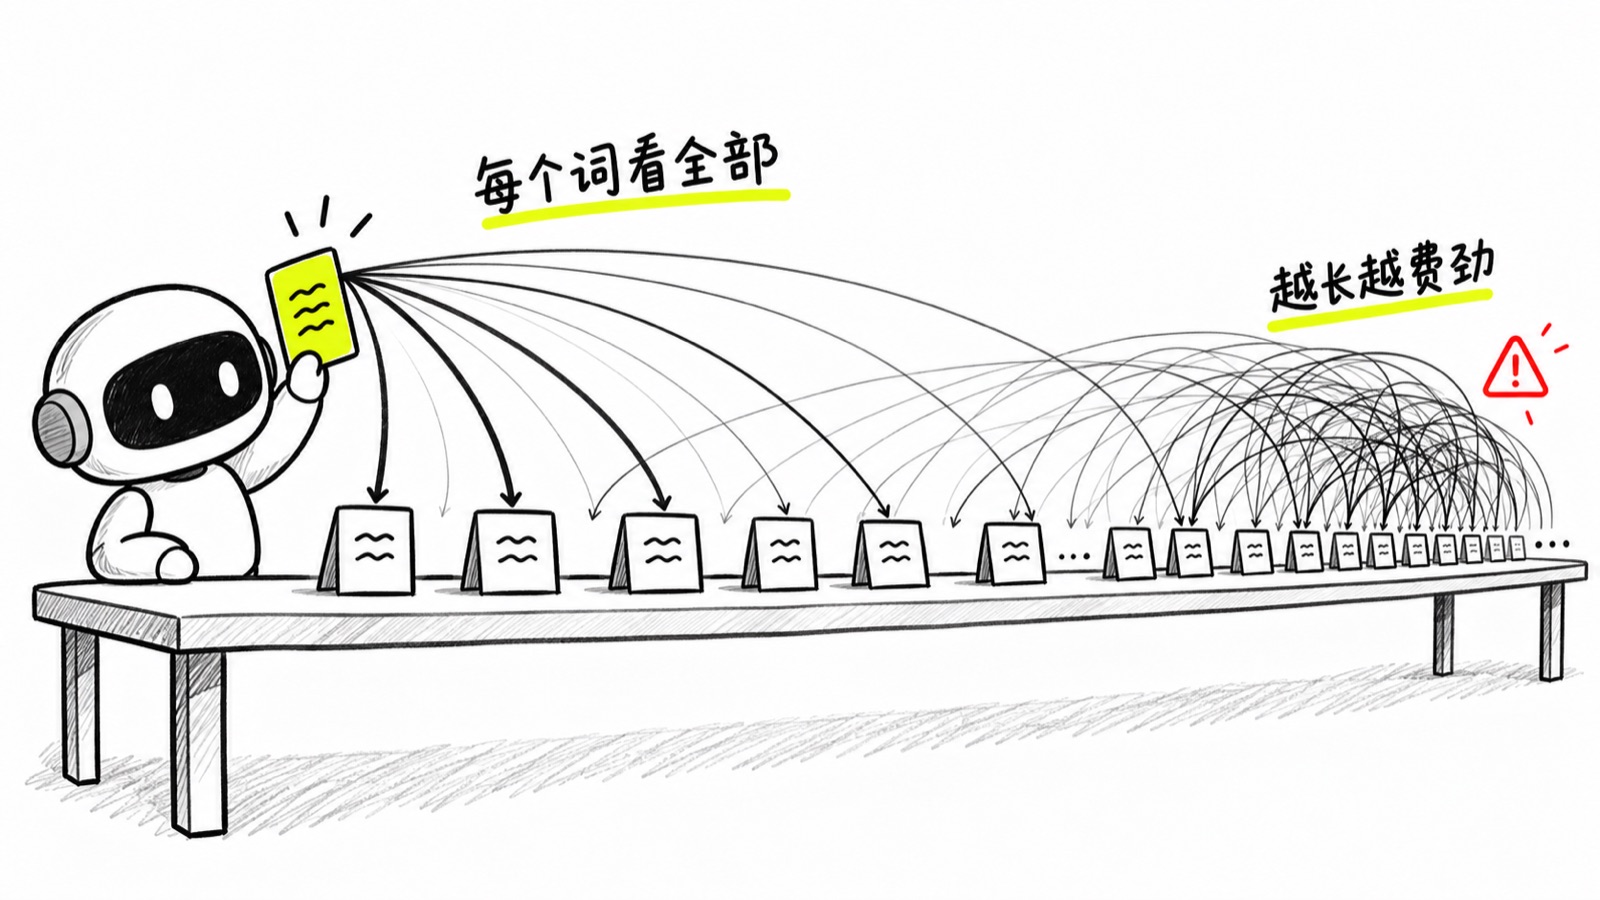
- 说人话
- 模型内部处理一句话的那套结构。在它出现之前,机器读句子要从头到尾一个词一个词地过,前面没算完后面动不了;它让句子里的词能同时互相参照、一起算,训练才铺得开,往后堆大模型才有了可能。你看到的 GPT,名字里的 T 指的就是它。
- 说行话
- 2017 年论文《Attention Is All You Need》提出的架构,核心机制英文名 self-attention。对话模型几乎都是它的 decoder-only 变体;注意力开销随序列长度呈平方增长,上下文翻一倍就变四倍。
- 潜台词
- 「基于 Transformer」在今天几乎等于没说,主流大模型都是这个结构。
- 别用它
- 不做模型研发的人不必啃它的数学细节。知道注意力的计算量随上下文变长涨得很快,就足够指导日常决策。
拿这个能做什么3 个项目
- 01
- 02
- 03
看懂 Transformer 不用啃公式,抓住一件事就够:每生成一个 token,都要回头和前面所有 token 算一遍关系。上下文窗口为什么有上限、长输入为什么又贵又慢,根子都在这里。
动手试试做完就算会了
在项目清单里 poloclub 那个可视化站点输入一句英文,点注意力那块展开,看 Scaling · Mask 那张矩阵:右上半个三角全是灰点,每个词看不到它后面的任何词。预训练那步的 nanochat 猜下一个词不偷看答案,靠的就是这块灰三角。