LLM
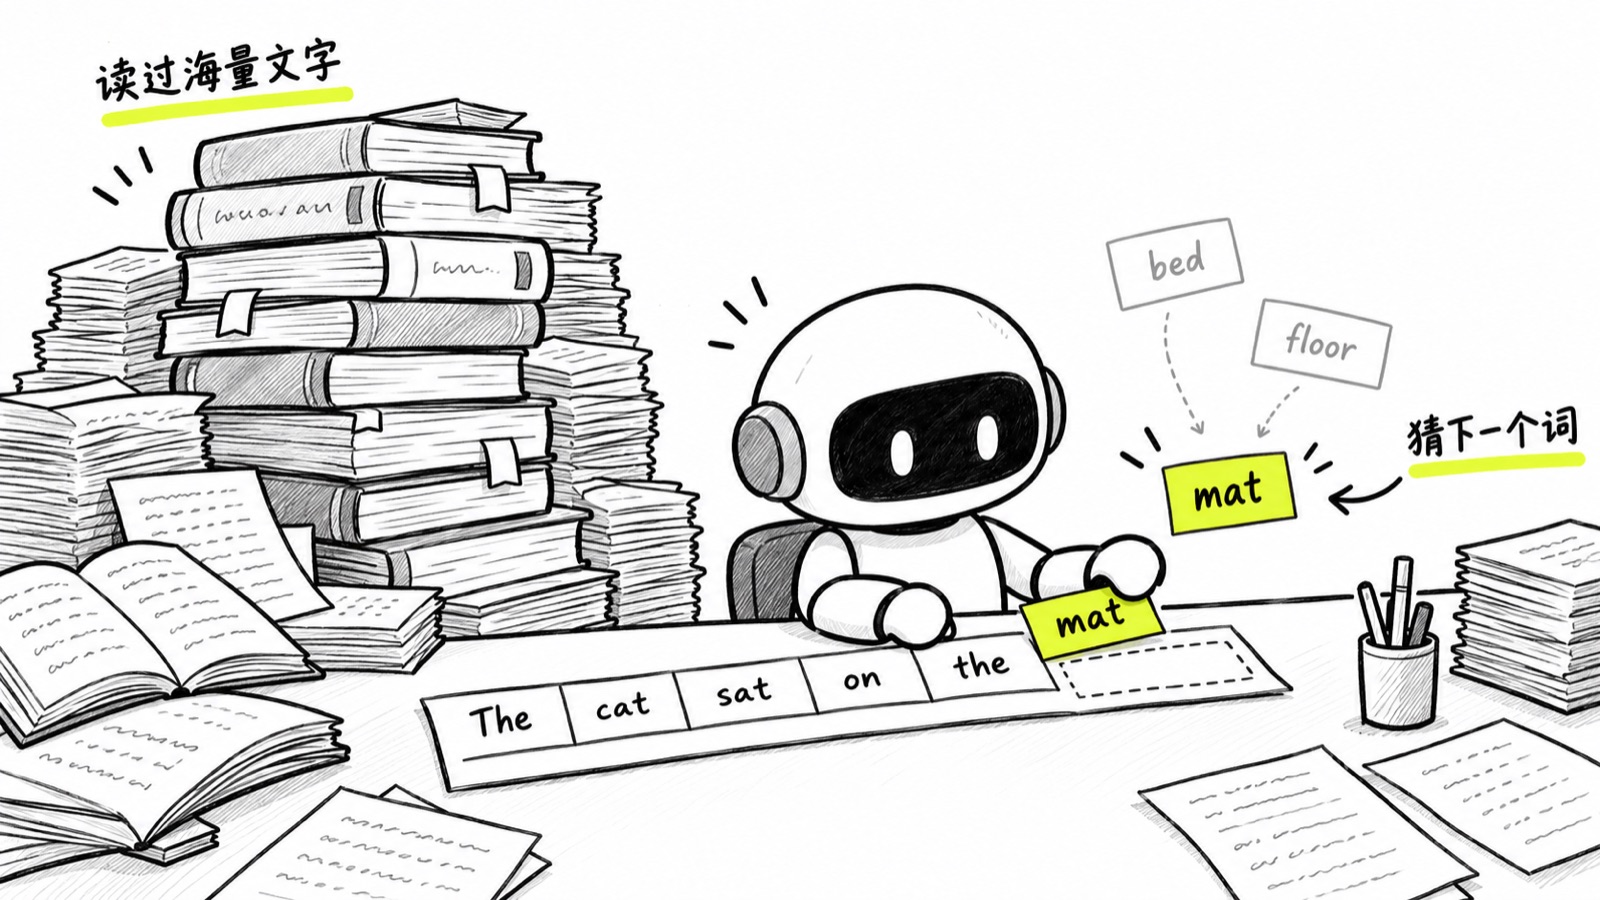
- 说人话
- 一个把海量文字读过一遍、把里面的规律压进内部一大堆数字里的程序。你给它一段话,它就照这些数字算出下一个字最可能是什么,一直算下去,整段回答就这么长出来。它不查数据库,这堆数字停在训练结束那一刻,所以问它今天的新闻,它要么答不上来,要么编一个。
- 说行话
- 全称 Large Language Model。同一家通常出大中小几个型号,API 里靠 model 字段指定用哪一个。计费分输入和输出两项,输出单价通常是输入的好几倍,所以长回答比长提问贵得多。
- 潜台词
- 「我们接入了大模型」,多半意思是调用了某家的 API,自己没有训练过任何东西。
- 别用它
- 能用规则、正则或查表解决的事别上 LLM。它慢、贵,同一个问题每次答得还不完全一样。
拿这个能做什么4 个项目
- 01
- 02
- 03
- 04
LLM 本质上是一个只会续写的函数:进去一段字,出来下一段字。记忆、联网、调工具都是外面包的壳。模型之间的差距在缩小,产品之间的差距在模型之外:喂什么上下文、接什么工具、出错怎么兜底。
动手试试做完就算会了
在装好 Ollama 的终端里跑 ollama run qwen2.5:1.5b,它先下载再进入对话,问它两句,另开一个终端敲 ollama list,SIZE 那列写着 986 MB。关掉 Wi-Fi 接着问,照样答得上来:跟你对话的,就是硬盘上这一个不到 1GB 的文件。