推理模型
- 说人话
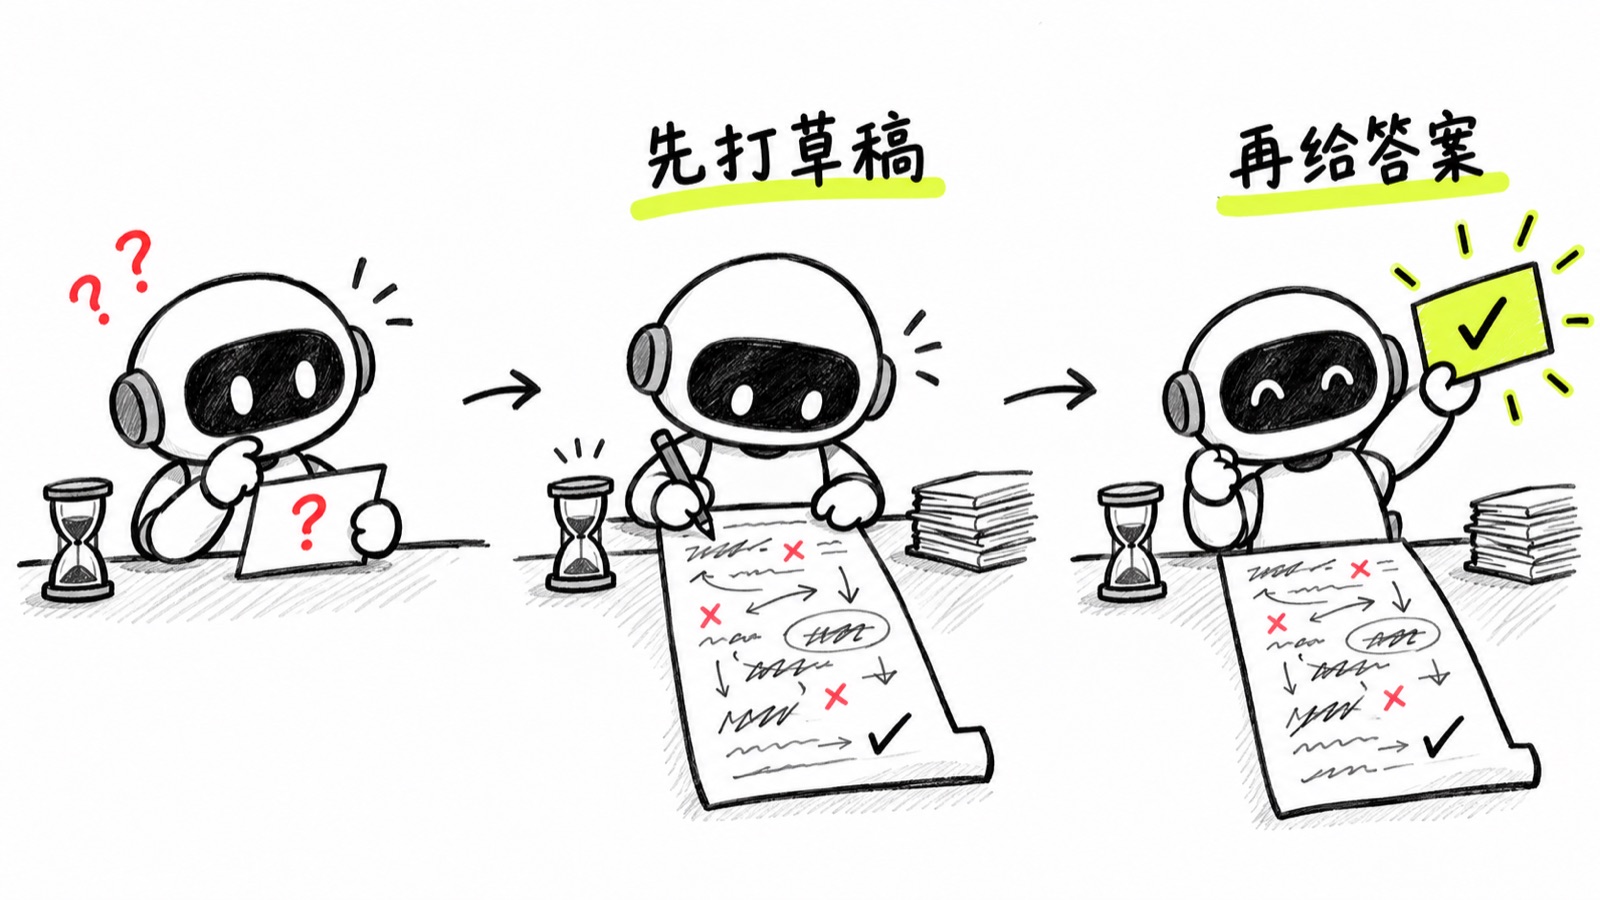
- 回答前先在内部写一长串草稿的模型。草稿里它会拆步骤、算到一半发现路走不通、掉头重来,数学题和长代码这类一步错就全错的活儿,靠这几圈自己绕了回来。你在界面上看到的「思考中」、那块能展开的思考过程,就是这段草稿,代价是等第一个字出来要久得多。
- 说行话
- 接口上多出控制思考长度的参数,有的叫 reasoning_effort,有的给思考留一个 budget_tokens 预算。用量里也会多出 reasoning tokens 这一项,按输出价计费,内容未必给你看。
- 潜台词
- 「开个深度思考」就是让它多想一会儿,多想的那些 token 同样算钱。
- 别用它
- 简单问答、改写、翻译别用。它会想很久,答案却不见得更好,还更慢更贵。
拿这个能做什么3 个项目
- 01
- 02
- 03
给推理模型写提示词要反着来:别教它怎么想,只说清目标、约束和怎样算做对。「一步一步思考」这类老套路放在它身上多半是多余的,省下的篇幅留给背景信息。
动手试试做完就算会了
跑 ollama run qwen3:1.7b --verbose "strawberry 里有几个 r",它先滚出一屏 Thinking 草稿再作答,记下末尾的 eval count 和 total duration。加 --think=false 再问一次,只回一两行,两个数都缩了好几倍。