AIGC工作流
用Hypit复刻一切爆款视频
整条链路其实只有三件事:装好 Skill → 配好 key → 让它开始复刻。中间所有环节(拆片、写脚本、生成素材、渲染成片)都由 AI 完成,你只需要做决定。
一、实操
第一步:装 Skill
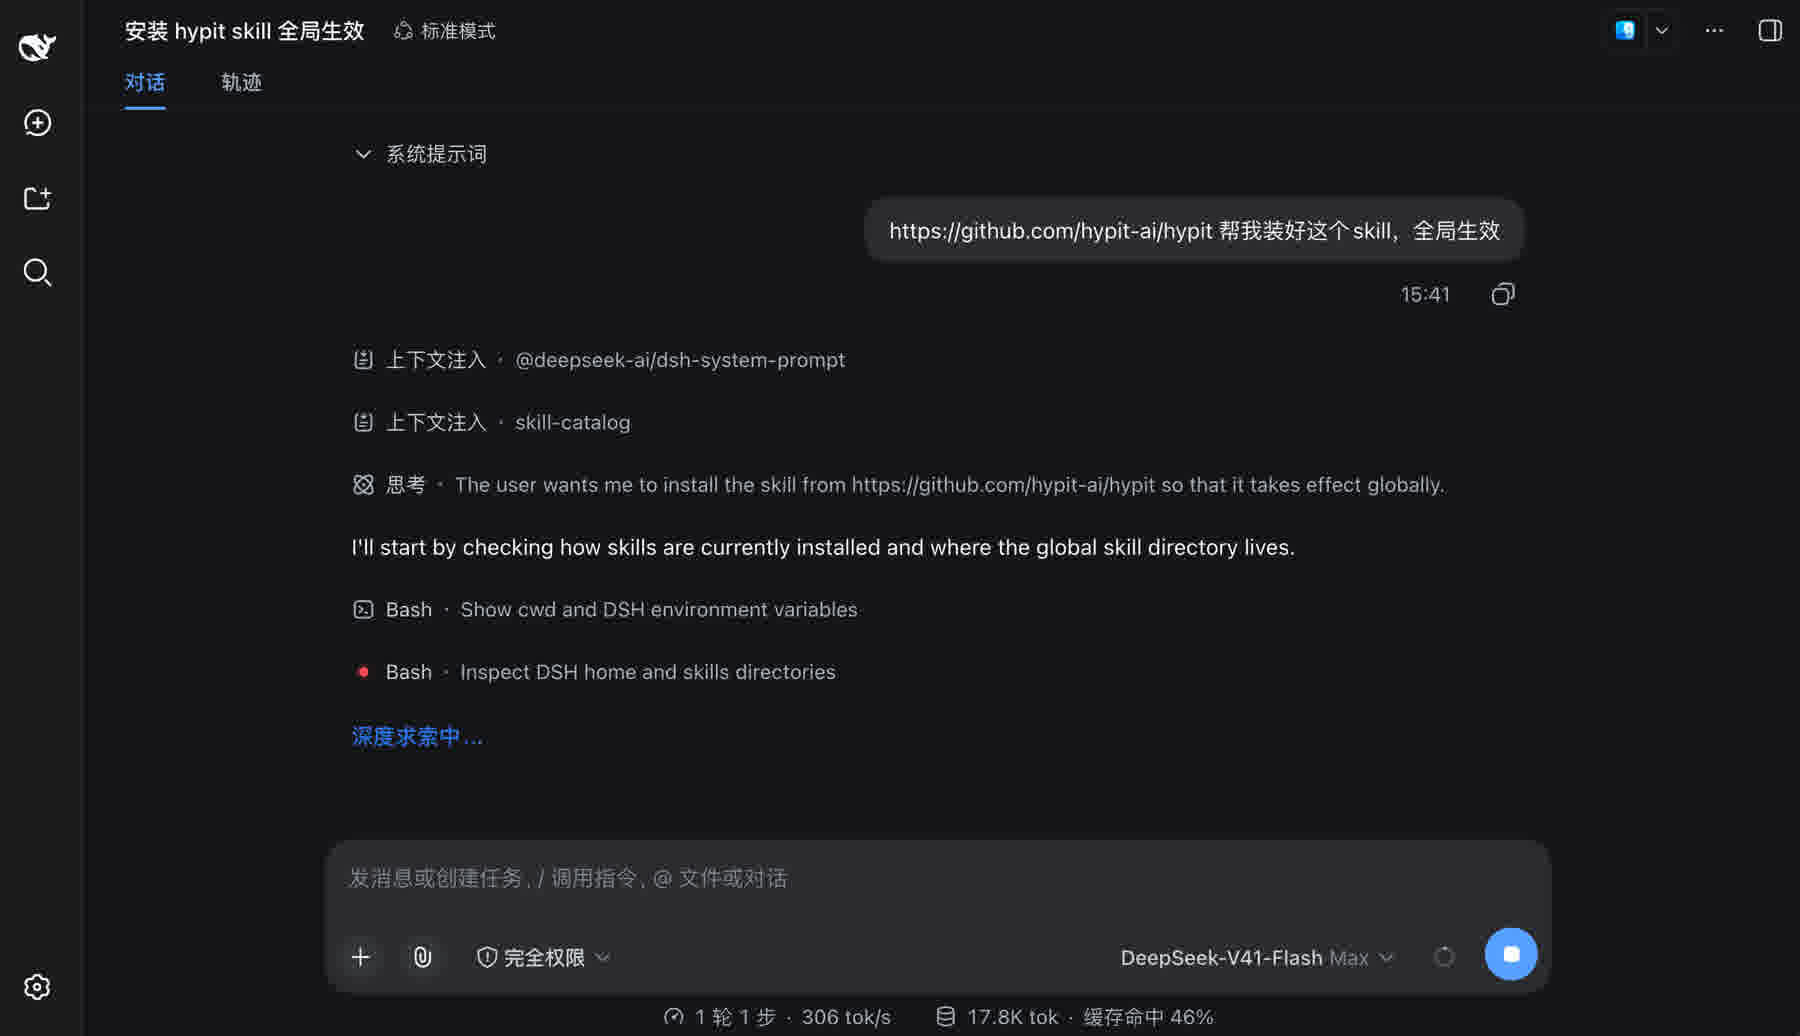
Hypit 不是一个网页应用,它是一份给 Coding Agent(Claude Code / Codex)用的 Skill。所以你不用敲任何终端命令,把这句话原样发给 AI:
https://github.com/hypit-ai/hypit 帮我装好这个skill,全局生效AI 会自己把 Skill 装到全局目录并回报。之后任意目录开新会话,打 / 就能在斜杠菜单里看到 hypit。
第二步:搞定配置
配置只有两件事:拿 key,以及把 key 发给 AI。依赖怎么装、配置怎么写,全交给 AI。
先看这张表:这是我实际用的配置
# | 干什么 | 用哪个 | Key 来源 |
|---|---|---|---|
1 | 理解需求、编排流程 | DeepSeek V4.1 Flash | 不用,Agent 自带 |
2 | 分析参考视频 | DeepSeek V4.1 Flash(带视觉) | 不用,Agent 自带 |
3 | 人物及主要图片 | Seedream 5.0 Lite · 文生图 | 火山方舟 |
4 | 界面与卡片 | Seedream 5.0 Lite · 文生图 | 火山方舟 |
5 | 补充图片 | Seedream 5.0 Lite · 文生图 | 火山方舟 |
6 | 图片精修、换材质换场景 | Seedream 5.0 Lite · 图生图 | 火山方舟 |
7 | 人物讲话视频 | Seedance 2 Mini | 火山方舟 |
8 | 产品操作短片 | Seedance 2 Mini | 火山方舟 |
9 | 统一声音参考 | MiMo V2.5 VoiceDesign | 小米 MiMo |
10 | 识别口播、对齐字幕 | WhisperX | 不用,本地 |
11 | 绘制字幕、排版、图形 | 本地代码组件 | 不用,本地 |
12 | 合成、导出 | HyperFrames + FFmpeg | 不用,本地 |
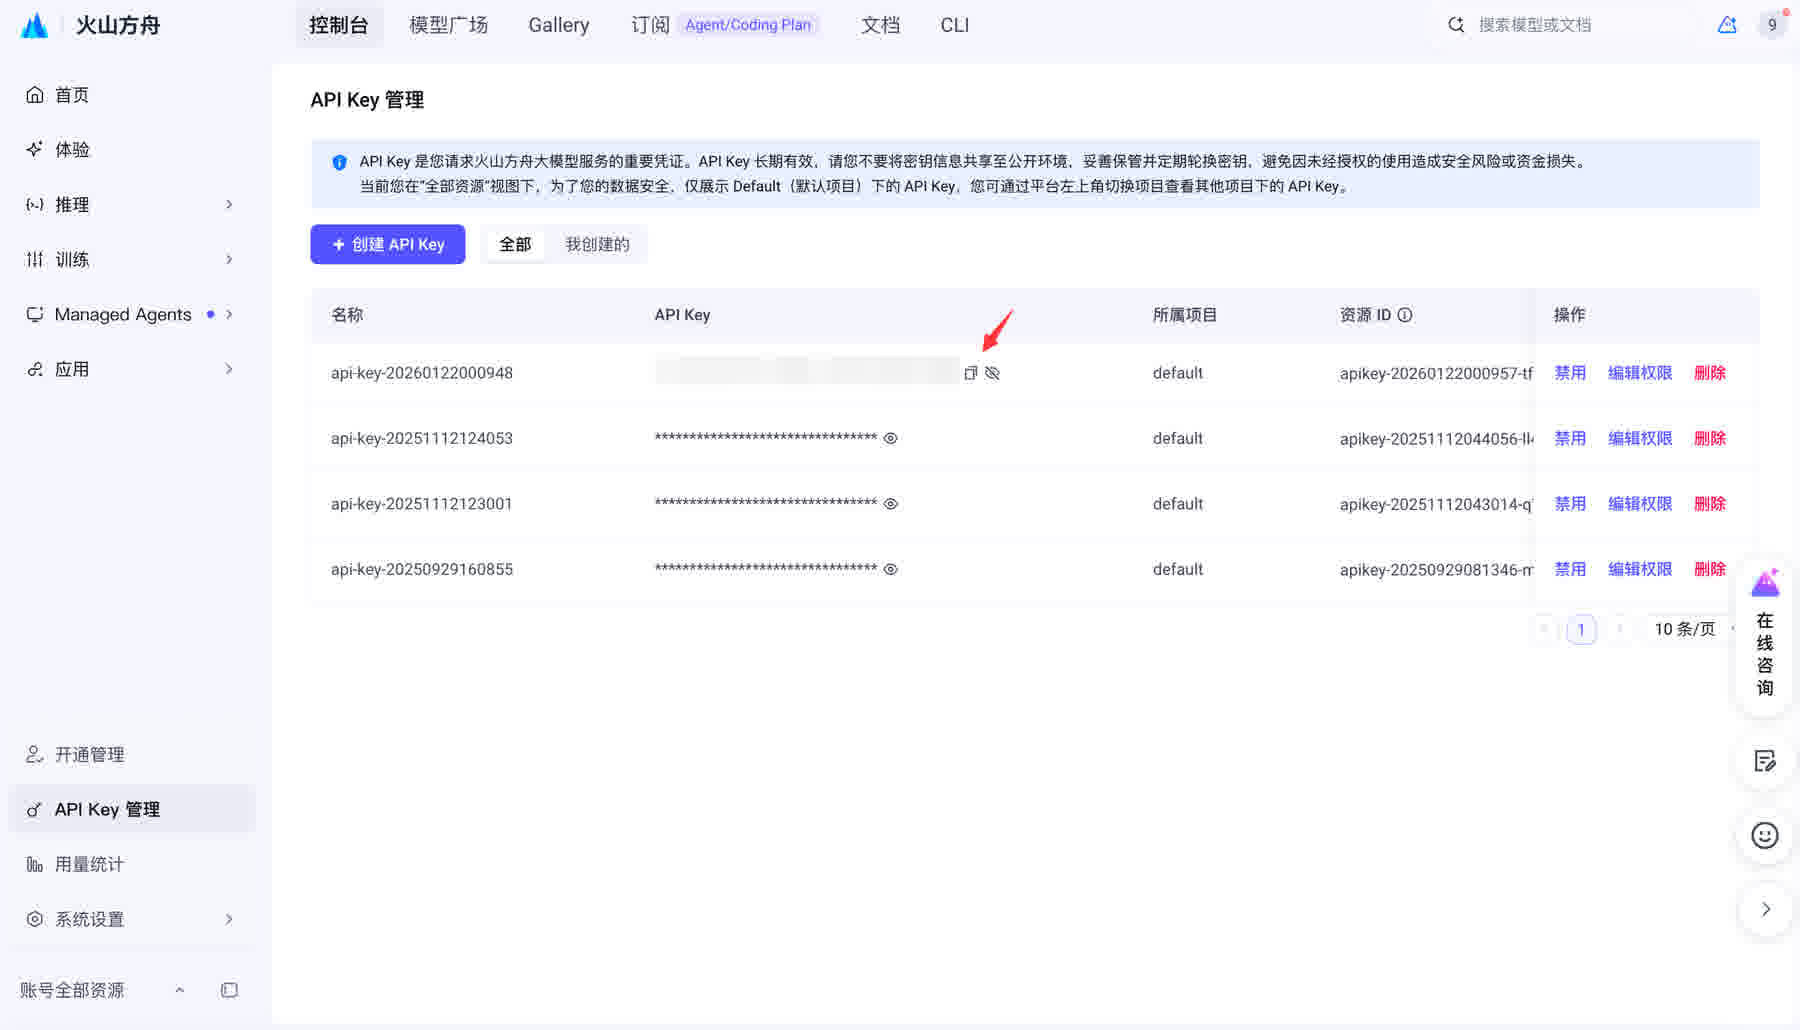
拿火山方舟的 Key
- 注册登录火山引擎,进入 火山方舟 控制台
- 先充值:火山方舟需要预充值 ¥200 才能开通模型服务
- 在「开通管理」里分别开通 Seedream(图片)和 Seedance(视频)
- 到「API Key 管理」创建一个 Key。只显示一次,当场复制
拿小米 MiMo 的 Key
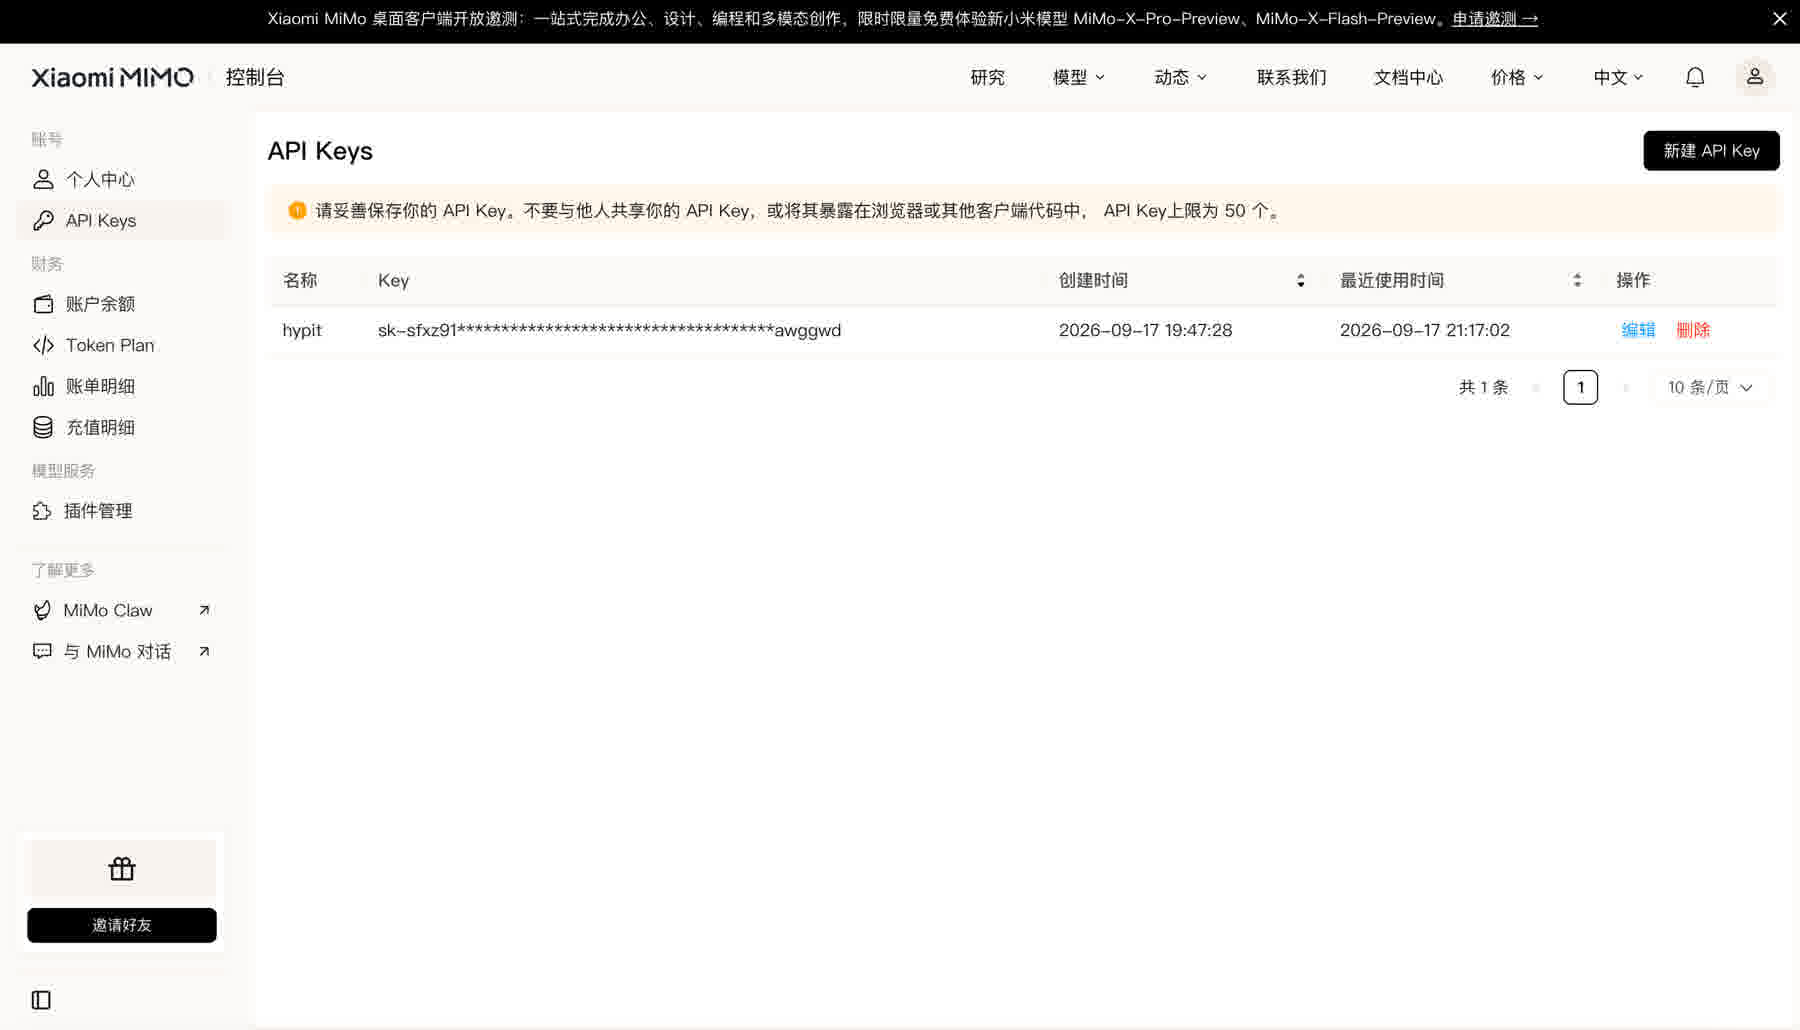
- 进入小米 MiMo 开放平台,完成账号注册与实名
- 先充值:预充值 $3 就够了
- 在控制台创建一个 API Key,当场复制
一个必须知道的细节:MiMo VoiceDesign 没有持久的音色 ID,每次调用都按描述重新造一个声音。所以想让多条视频用同一个嗓子,唯一的办法是把第一次生成的那段音频存下来当参考复用。我两条案例共用一个主播声音就是这么做的。
把配置和 key 一起发给 AI
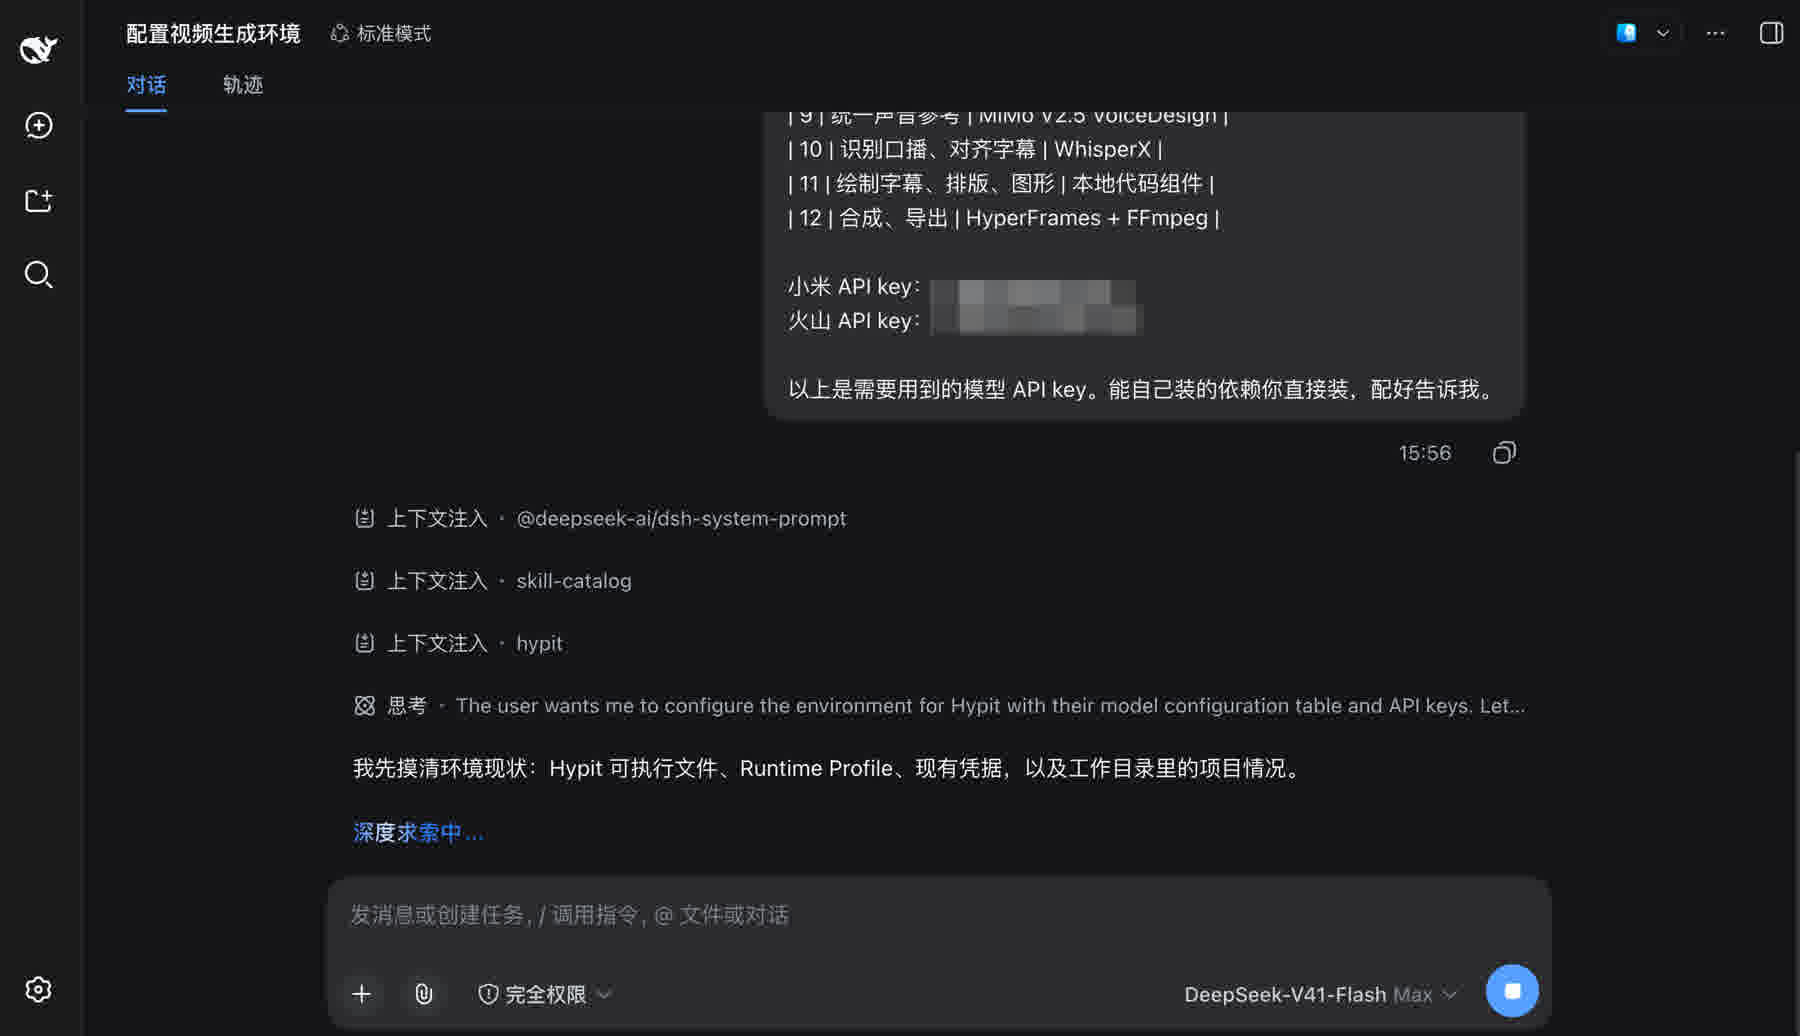
两个 key 拿到手之后,连同上面那张配置表一起发给 AI,这段就是配置的全部内容。它读完之后会自己把依赖装掉、把供应商接上、把环境验通,然后告诉你「可以开工了」。
下面这段可以直接复制。表格用 Markdown 写,AI 读起来最准。
/hypit 根据这个 skill 帮我配好环境和模型。以下是我的配置:

| # | 干什么 | 用哪个 |
| --- | --- | --- |
| 1 | 理解需求、编排流程 | 当前 Agent 平台 |
| 2 | 分析参考视频 | 当前 Agent 平台 |
| 3 | 人物及主要图片 | Seedream 5.0 Lite · 文生图 |
| 4 | 界面与卡片 | Seedream 5.0 Lite · 文生图 |
| 5 | 补充图片 | Seedream 5.0 Lite · 文生图 |
| 6 | 图片精修、换材质换场景 | Seedream 5.0 Lite · 图生图 |
| 7 | 人物讲话视频 | Seedance 2 Mini |
| 8 | 产品操作短片 | Seedance 2 Mini |
| 9 | 统一声音参考 | MiMo V2.5 VoiceDesign |
| 10 | 识别口播、对齐字幕 | WhisperX |
| 11 | 绘制字幕、排版、图形 | 本地代码组件 |
| 12 | 合成、导出 | HyperFrames + FFmpeg |

小米 API key:<你的 MiMo Key>
火山 API key:<你的火山方舟 Key>

以上是需要用到的模型 API key。能自己装的依赖你直接装,配好告诉我。换模型只改这张表。想换更贵的视频模型出 1080p、或者把声音换成别家,改表格里对应那一行重新发一次就行,视频源码一个字都不用动。
第三步:开始复刻
配置好了,一句话开工:
/hypit 复刻这个视频:/path/to/reference.mp4接下来 AI 会自己走完剩下的路:
- 拆解参考片:下载、词级转写、逐帧读图,读懂它为什么抓人
- 写 Source:用它自创的视频语言 SVML,把这条片子写成可以重跑的源码
- 报价:先列出这次要发哪些付费请求、单价多少(这一步不花钱)
- 构建:生成素材、渲染成片
- 给你看片:你提意见,它改,再跑一遍
返工几乎不花钱。改字幕、改排版、改画幅、改抠图算法全是本地计算,0 元;已经生成的图和口播视频,由 Agent 在运行文件里点名复用,不会重复付费(原理见下文 Q4)。只有换台词、换语言、换人,才需要重新生成。
二、原理拆解
先对齐一个事实:它和现在两种主流做法的区别在哪。
让 AI 操作剪辑软件 | 让 AI 直接写动画代码 | Hypit | |
|---|---|---|---|
动效 | 贴图还行,动效难:要么让 AI 在时间轴上标二十几个时间点,烧掉几十万 token;要么让视频模型直出,效果不稳,样式也改不了 | 想怎么做就怎么做 | 一样自由:底层渲染用的就是 HyperFrames |
做下一条 | 从头再贴一遍 | 几千行代码再抄一遍 | 组件照用,只换参数 |
稿子一改 | 时间点全部重标 | 时间点全部重算 | 画面跟着词走,时间点一个不用动 |
Hypit 不是第三条路。它走的就是写代码这条路,只补了两层:一层管时间,让画面挂在词上;一层管复用,把动效做成组件。下面五个问题,按你用它时会碰到的顺序往下拆。
Q1 复刻,复刻的到底是什么?
是关系:每一次画面变化,在回应哪句话、哪个词。人、产品、台词都可以换,关系留下。
Skill 交给 Agent 的第一件事是读片:一边看逐帧画面,一边看带时间的逐词转写,找出每一次切镜、出图、揭晓、音效在回应什么,再在新台词上把同样的关系搭回去。Skill 里的原话是:参考片的秒数只用来定位证据,新片的时间由新的表演提供。
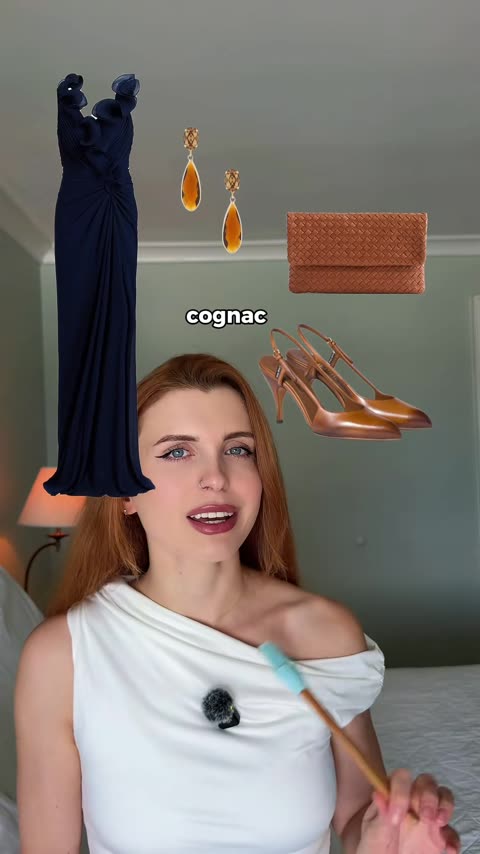
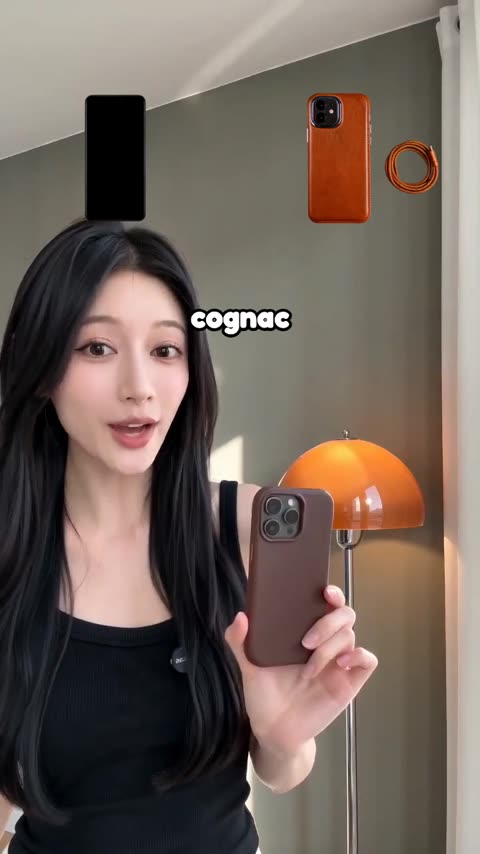
读片读出的关系 | 写进新稿子的方式 |
|---|---|
配饰卡在颜色词上出现:说到 silver,右边亮出银鞋 | 每组拆成 |
左边主体先出,右边配饰后出 | 主体从 |
屏幕上一次只亮一个词 | 词与词之间写 |
每组最后一个形容词带星芒 | 写成 |
案例 2 复刻版的稿子,第一组(为排版折了行):
<HOST>@{phone-a-lead} A || black || phone || with || a @{/phone-a-lead} ||
      @{phone-a-color} clear || case || is || the || safe || choice @{/phone-a-color}
      @{phone-b-lead} but || with @{/phone-b-lead} ||
@{phone-b-color} cognac || leather || it || looks || far || more || <✦expensive✦ | expensive> @{/phone-b-color}画面、品类、台词全换了,这四条关系一条没丢,这就是复刻。反过来,拆片时漏读一条关系,成片就形似神不似,所以实操里说这一步最致命。
Q2 「动效绑在词上」,是怎么做到的?
稿子里只有词,没有一个秒数。时间是在配音生成之后,从真实的声音里量出来的。
环节 | 做什么 | 成本 |
|---|---|---|
01 写稿 | 只写要说的话。要跟着话走的画面,就在词上打锚点:一段话用 | 不花钱 |
02 表演 | 让模型把稿子说出来:Seedance 生成口播视频,或者配音模型生成声音。 | 花钱 |
03 对齐 | WhisperX 拿着稿子去听这段声音,给每个字标出它落在第几帧。 | 本地 0 元 |
04 排时间线 | 各段表演首尾接好,锚点跟着自己挂的词拿到全片帧号。时间线到这一步才出现。 | 本地 0 元 |
05 渲染 | 字幕、榜单、抠像按帧号出场,HyperFrames 用无头 Chrome 逐帧画出来,再编码成 MP4。 | 本地 0 元 |
<HOST>今天的@{reveal!}第一名,就是@{product}Hypit,一起看看。@{/product}组件那一侧,只认锚点的名字(节选):
<ranking:TopThreeItem label="Hypit" at={story.moment.reveal}/>
<media-track:Item image={product.image} … during={story.selection.product}/>所以时间线不是写出来的,是量出来的:稿子怎么改、配音换成谁,画面都跟着词走。反过来也成立,台词一改,这段表演就得重新生成,因为时间来自它。
Q3 动效为什么能写一次、反复用?
因为组件只管「怎么动」。内容、时间、位置、样式四样东西,全从外面传进去。
直接写动画代码时,这四样是写死在同一个文件里的:「第 3.2 秒,左上角,这行字,这样飞进来」。下一条视频四样全变,只能重写。Hypit 把它们拆成组件的参数,拿官方的榜单组件举例:
<ranking:Column frame={board-frame} style={board-style} …>
  <ranking:ColumnItem rank="1" label="Hypit" icon={icon-hypit}
    during={story.selection.hypit-reveal}/>
</ranking:Column>
参数 | 归哪一类 | 管什么 |
|---|---|---|
| 内容 | 排第几、叫什么、配哪张图 |
| 时间 | 挂在稿子的哪段话上 |
| 位置 | 放进画面上的哪个框 |
| 样式 | 颜色、字号、动效节奏,写在 |
组件的代码只负责剩下那件事:条目怎么进场、怎么排到自己的位置。下一条视频换掉这四样参数,代码一行不动。
现成的和现写的,是同一套接口。官方已经带了逐词高亮字幕、榜单、卡片堆、评论贴纸、文字层、画中画与 B-roll、11 种全屏特效。没有的效果,Agent 按同一套接口现写一个项目组件(本质是一段 HTML/CSS 程序),这个项目以后接着用。
Q4 返工为什么几乎不花钱?
作品写在一份文件里,「这一次跑什么」写在另一份里。花过钱的产物都留着,下次点名就能接着用。
文件 | 是什么 | 里面写什么 |
|---|---|---|
| 作品本身 | 稿子、要生成哪些素材、用哪些组件、成片怎么拼 |
| 样式与配方 | 颜色、字号、动效参数、提示词配方,写法像 CSS |
| 这一次 | 这次要产出什么,哪些沿用以前的结果 |
每次 build 的产物都存进项目的 .hypit/results/。改字幕时,Agent 在 .svrun 里写明「口播视频用上次那两段」,plan 就把对应的生成请求剪掉,剩下的对齐和渲染都在本地跑。这是案例 2 真实的运行文件:
<!-- 两段口播已由 Seedance 生成并付费:显式复用,重跑只做本地工作 -->
<build-record id="kept-part-one"
  build="bld_20260917T154106043Z_BD20FF7B3B" output="part-one-take.video"/>
<satisfy output="part-one-take.video" candidate="kept-part-one"/>没有「自动复用」这回事。官方文档原话是「Hypit 没有隐式缓存」:prompt 没变也不会自己复用,必须在 .svrun 里点名。好处是 plan 里看得见哪些请求被省掉,不会悄悄重复扣钱,也不会把改过的素材错当成旧的。
想改什么 | 改哪一处 | 要不要重新生成 |
|---|---|---|
字幕样式、颜色、字体 |
| 不用,本地重新渲染 |
画面上的文字、榜单条目 | 组件参数 | 不用 |
某个动效挂在哪个词上 | 挪锚点 | 不用,本地重新对齐 |
只改字幕显示的字,配音不变 | Dual Text 的左边 | 不用 |
台词、语言 | 稿子 | 要:口播重新生成,时间来自它 |
人物、产品、场景 | 生成请求的 prompt 或参考图 | 要:只重生成改动的那几个 |
换模型、换供应商 | Runtime Profile 的绑定 | 视频源码不动,按新服务计费 |
花钱之前还有一道闸:只有 build 会真正发出请求。plan 先列出这次要发哪些付费请求,pricing 读出对应单价。中途失败也不白花,这次 Build 结束,已经完成的产物留在结果里,下一次点名接着用。
Q5 换模型,为什么不用改视频?
视频源码只写「要什么」,「找谁要」写在另一份配置里。
源码里写的是 Model,比如「要一段 Seedance 2 Mini 的口播视频」。执行时,hypit.runtime.json 把每一种能力绑到一个服务入口:哪家服务、哪个 Key、开几路并发。真正去调 API 的是 Provider 包。这是我这套配置的真实绑定:
"bindings": {
  "@hypit/seedream@1#seedream-5-lite":              "framelab.ark",
  "@hypit/seedance@1#seedance-2-mini":              "framelab.ark",
  "@hypit/mimo-speech@1#mimo-v2.5-tts-voicedesign": "framelab.mimo",
  "@hypit/whisperx@1#whisperx-alignment":           "whisperx.local",
  "@hypit/render-hyperframes@1#render-visual":      "hyperframes.local"
}左边是要什么,右边是找谁要:ark 是火山方舟,mimo 是小米 MiMo,local 是本机。你在第二步 发给 AI 的那张表,最后就变成了这几行。换供应商改的是右边,视频源码一个字不动。
官方没接的服务,也能现接。火山方舟不在官方内置的供应商里,这里的 framelab 是这个项目自己写的一个 Provider 包(在 packages/provider-framelab),用来接火山方舟和小米 MiMo。另外,生成模型本身也是可选的:一条片子可以完全由组件画出来,不调任何模型,模型费用就是 0。
三、它做不到什么
- 台词一改,口播就得重新生成。时间来自表演,这笔钱省不掉。
- 像不像,看 Agent 读片细不细。我第一版每 2 秒取一帧,漏了逐词字幕和「左先右后」的入场,返工了一整轮。
- 好不好看,看生成模型当天的发挥。Hypit 管组织,不训练模型,也不替你抽卡。
- 没有口播的纯动画,没有词可挂。节奏得自己用秒或帧来写。
- 协议是改过的 Apache 2.0。自家业务、给客户做片都能商用;做多租户 SaaS 或拿它转售,要另买商业授权;做出来的成片归你。
- 本机不轻。要 Node 22.15 以上;本地 WhisperX 和逐帧渲染吃 CPU 和内存,嫌重可以换官方托管的 HypiHub。